Las traducciones son generadas a través de traducción automática. En caso de conflicto entre la traducción y la version original de inglés, prevalecerá la version en inglés.
Tablas de streaming y entrega de S3 para Amazon Kinesis Data Streams
Con Amazon Kinesis Data Streams, puede entregar datos de streaming desde sus transmisiones de datos de Kinesis a dos tipos de destino: tablas de streaming en Apache Iceberg (tablas de Amazon S3) o cubos de Amazon S3 de uso general. No necesita administrar ninguna infraestructura y puede empezar a realizar entregas en cuestión de minutos. Amazon Kinesis Data Streams lee la transmisión, almacena en búfer y agrega los registros y los envía al destino que haya configurado. La entrega está totalmente gestionada: no hay conectores, aplicaciones de consumo ni recursos informáticos que aprovisionar.
Estas capacidades son compatibles con las transmisiones que se ejecutan en los modos de capacidad On-Demand Advantage o On-Demand Standard. Tú configuras la entrega desde tu transmisión y especificas un destino. A continuación, Amazon Kinesis Data Streams gestiona automáticamente el escalado, los reintentos y la fiabilidad de la entrega. La entrega no consume el rendimiento de lectura de la transmisión y no afecta a los consumidores actuales.
Temas
Cómo funciona la entrega de datos
La entrega de datos conecta su transmisión de datos de Kinesis con un destino de entrega a través de una canalización administrada:
Los datos se publican en una transmisión de datos de Kinesis en On-Demand modo.
Usted invoca
CreateChannella transmisión y especifica un destino (tablas de transmisión en Apache Iceberg o un bucket de Amazon S3 de uso general).La entrega lee la transmisión, almacena los registros en búfer y los agrega en archivos de tamaño óptimo.
La entrega escribe los archivos en el destino que configuraste dentro de la ventana de actualización de datos que especifiques.
Destinos de entrega
La entrega de datos admite dos tipos de destino:
- Tablas de streaming en Apache Iceberg
-
Streaming Tables entrega de forma continua su transmisión de datos de Kinesis a tablas de Apache Iceberg almacenadas en Amazon S3 Tables. A medida que llegan los datos, se convierten automáticamente al formato Apache Parquet optimizado con una compactación en línea inteligente que elimina el problema de los archivos pequeños y reduce los costos de las consultas posteriores. A los pocos minutos de publicarlos en su transmisión, los datos se pueden consultar a través de Amazon Athena, Amazon EMR, Amazon Managed Service para Apache Flink o cualquier motor compatible con Apache Iceberg.
- Buckets de Amazon S3 de uso general
-
La entrega de Amazon S3 escribe los datos de streaming de su transmisión de datos de Kinesis directamente en un bucket de S3. Los registros se entregan en su formato original sin que se aplique ninguna transformación. Los registros múltiples se almacenan en búfer y se agrupan en objetos de tamaño óptimo, con una compresión configurable y una estructura de claves S3 que se define mediante la plantilla de claves de salida. Esto resulta ideal para casos prácticos como el archivado de registros sin procesar, la reproducción de eventos y el procesamiento por lotes posterior, en los que se necesita un almacenamiento duradero y de bajo costo de los datos de streaming sin la sobrecarga que supone gestionar un proceso de entrega.
Flujo de datos
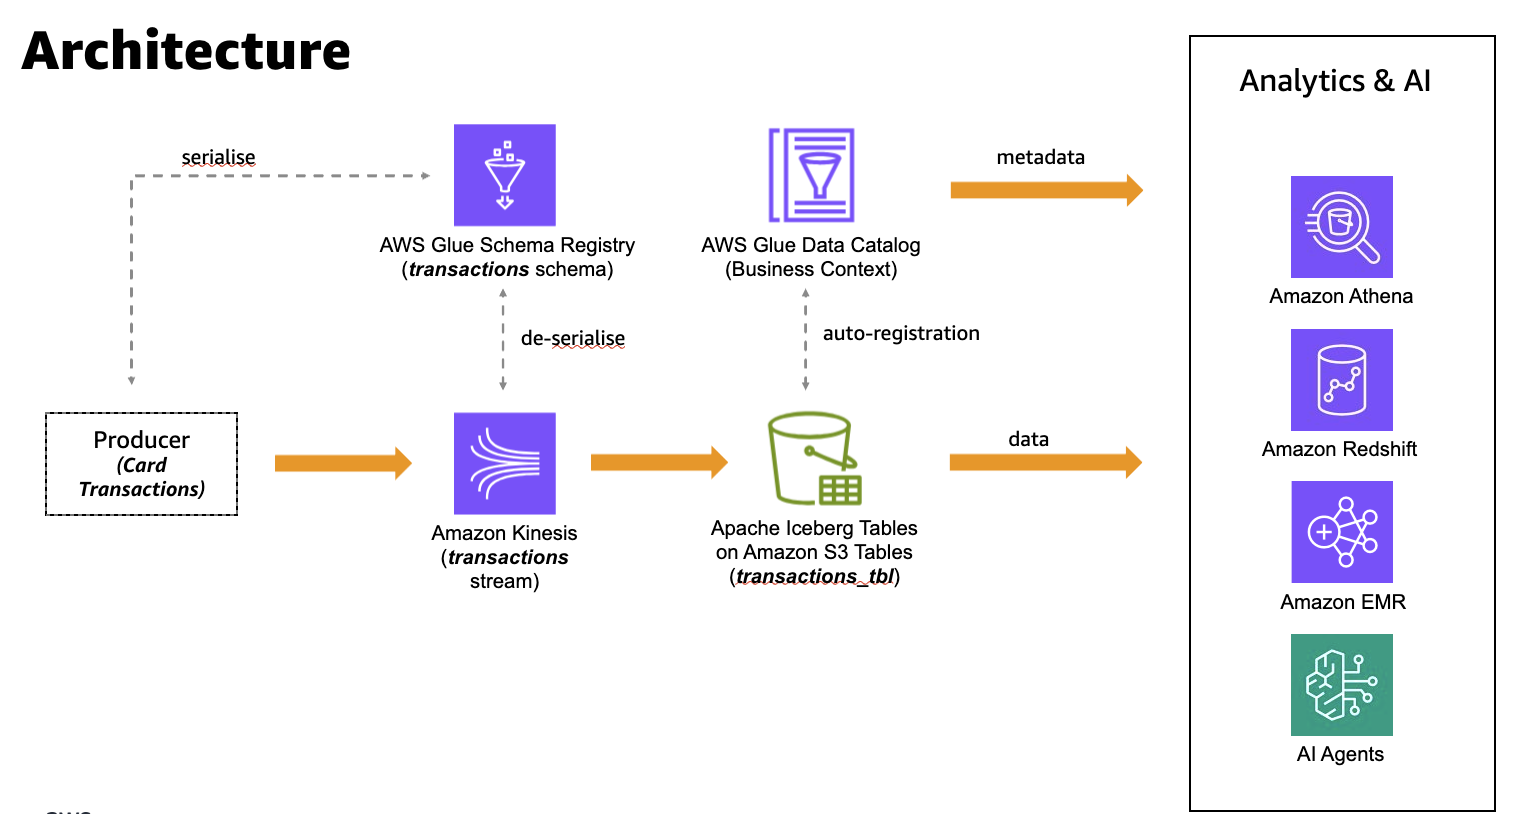
El siguiente diagrama muestra un flujo de datos de extremo a extremo para su entrega a las tablas de streaming en Apache Iceberg. El diagrama usa un caso práctico de transacciones con tarjeta como ejemplo. Un productor serializa los registros comparándolos con un esquema de Schema Registry y los escribe en una transmisión de AWS Glue datos de Kinesis. Amazon Kinesis Data Streams entrega los registros a las tablas de Apache Iceberg en las tablas de Amazon S3. Si habilita la integración del análisis en las tablas de S3, los metadatos de la tabla también se registran en el catálogo de AWS Glue datos; esto no ocurre de forma predeterminada. Los datos entregados y sus metadatos están entonces disponibles para los motores de análisis e inteligencia artificial, como Amazon Athena, Amazon Redshift y Amazon EMR.
La entrega a depósitos de Amazon S3 de uso general sigue un flujo similar, con dos diferencias. Un productor escribe registros en una transmisión de datos de Kinesis y Amazon Kinesis Data Streams los entrega a su bucket de S3. Los registros se entregan en su formato original sin conversión, por lo que no es necesario realizar AWS Glue el registro de esquemas y no se registra ningún metadato de tabla en el catálogo de AWS Glue datos. Amazon Kinesis Data Streams almacena en búfer y agrupa los registros en objetos de tamaño óptimo y los escribe con la estructura de claves de S3 que defina en la plantilla de claves de salida. Los objetos entregados están entonces disponibles para el procesamiento y el análisis por lotes posteriores.
Capacidades clave
Escalado automático sin servidor: se escala automáticamente en función del rendimiento de la transmisión, hasta la capacidad de rendimiento de la transmisión. No hay recursos informáticos que aprovisionar.
Exactly-once entrega por fragmento: los registros de un fragmento se entregan al destino exactamente una vez, sin duplicados ni omisiones en el fragmento.
Entrega casi en tiempo real: actualización de los datos configurable de 5 a 15 minutos (300 a 900 segundos).
Conversión automática de Parquet: en el caso de las tablas de streaming en Apache Iceberg, convierte los registros de streaming en un formato Apache Parquet optimizado para realizar consultas de análisis eficientes.
Compactación en línea: agrupa los registros en archivos de tamaño óptimo para mejorar el rendimiento de las consultas analíticas.
Cifrado: admite AWS KMS claves administradas por el cliente para el cifrado del lado del servidor en el destino. El Clave administrada de AWS (el
aws/kinesisalias) no es compatible con el cifrado de destino.Dead-letter cola: los metadatos de error de los registros que no se pueden entregar (incluidos el ARN de la transmisión, el ID del fragmento, el número de secuencia y el contexto del error) se escriben en una S3-based cola de correo muerto.
CloudWatch métricas y registros: supervise los bytes entregados, el recuento de registros y la actualización de los datos mediante las métricas de Amazon. CloudWatch Habilita el registro de entregas en Amazon CloudWatch Logs para recopilar los detalles de los lotes de entrega, los errores y el contexto de los errores para la resolución de problemas.
No afecta a otros consumidores: no consume ranuras distribuidas mejoradas ni capacidad de procesamiento compartida.
Requisitos
Su transmisión de datos de Kinesis debe usar el modo de capacidad On-Demand Standard o On-Demand Advantage.
Debe crear una función de ejecución del servicio de IAM que conceda los permisos de entrega para escribir en su destino.
Su bucket de destino o bucket de tabla debe estar en la misma región que su transmisión de datos de Kinesis. La entrega de datos no admite la entrega entre regiones para ninguno de los dos tipos de destino.
En el caso de las tablas de streaming en Apache Iceberg, no se admite la entrega entre cuentas. La transmisión de origen, el bucket de tablas de S3 de destino y el registro de AWS Glue esquemas deben estar todos en la misma Cuenta de AWS región.
En el caso de los buckets de Amazon S3 de uso general, solo se admite la entrega multicuenta para el bucket de destino. El canal y su transmisión de origen deben estar en el mismo lugar Cuenta de AWS; solo el bucket de destino puede estar en una cuenta diferente.
Para las tablas de streaming en Apache Iceberg, debe configurar una cola de mensajes muertos en Amazon S3.
