Les traductions sont fournies par des outils de traduction automatique. En cas de conflit entre le contenu d'une traduction et celui de la version originale en anglais, la version anglaise prévaudra.
Intégrer les OpenSearch pipelines Amazon Ingestion à d'autres services et applications
Pour réussir à ingérer des données dans un pipeline Amazon OpenSearch Ingestion, vous devez configurer votre application cliente (la source) pour envoyer les données au point de terminaison du pipeline. Votre source peut être des clients tels que Fluent Bit Logs, le OpenTelemetry Collector ou un simple compartiment S3. La configuration exacte varie d'un client à l'autre.
Les principales différences lors de la configuration de la source (par rapport à l'envoi de données directement à un domaine de OpenSearch service ou à une collection OpenSearch sans serveur) concernent le nom du AWS service (osis) et le point de terminaison de l'hôte, qui doit être le point de terminaison du pipeline.
Définition du point final d'ingestion
Pour ingérer des données dans un pipeline, envoyez-les au point de terminaison d'ingestion. Pour localiser l'URL d'ingestion, accédez à la page des paramètres du pipeline et copiez l'URL d'ingestion.
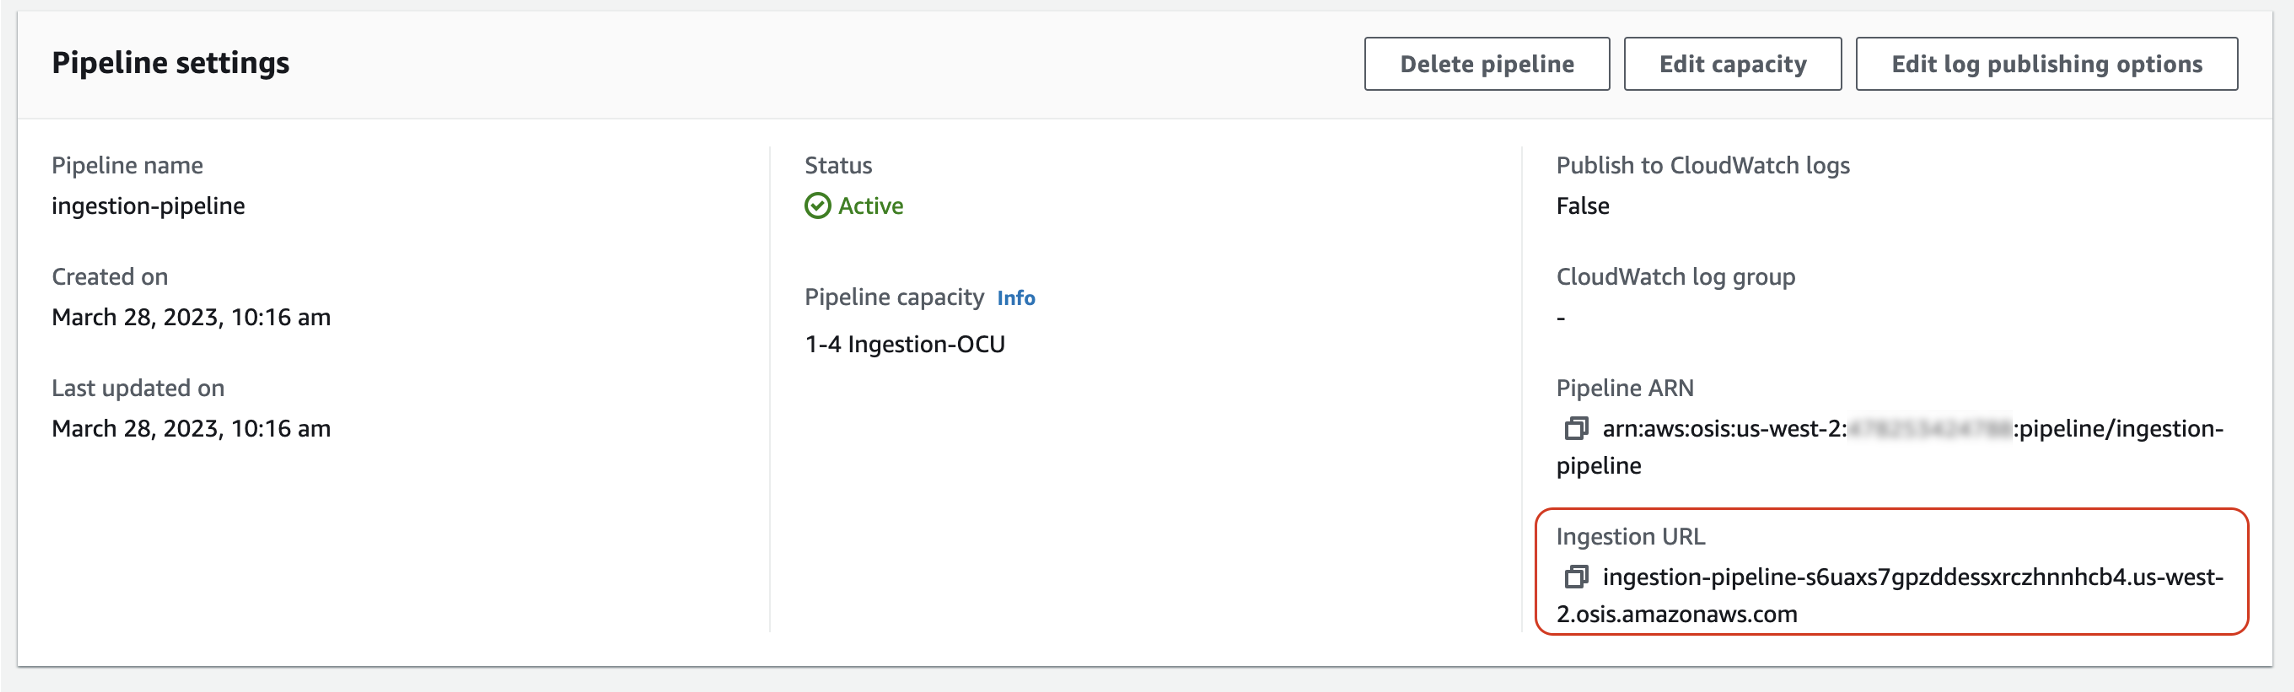
Pour créer le point de terminaison d'ingestion complet pour les sources basées sur l'extraction, telles que la trace
Par exemple, supposons que la configuration de votre pipeline possède le chemin d'ingestion suivant :

Le point de terminaison d'ingestion complet, que vous spécifiez dans la configuration de votre client, prendra le format suivant :https://.ingestion-pipeline-abcdefg.us-east-1.osis.amazonaws.com/my/test_path
Création d'un rôle d'ingestion
Toutes les demandes d' OpenSearch ingestion doivent être signées avec Signature Version 4. Au minimum, le rôle qui signe la demande doit être autorisé à effectuer l'osis:Ingestaction, ce qui lui permet d'envoyer des données vers un pipeline d' OpenSearch ingestion.
Par exemple, la politique Gestion des identités et des accès AWS (IAM) suivante permet au rôle correspondant d'envoyer des données à un seul pipeline :
Note
Pour utiliser le rôle pour tous les pipelines, remplacez l'ARN de l'Resourceélément par un caractère générique (*).
Fournir un accès à l'ingestion entre comptes
Note
Vous ne pouvez fournir un accès d'ingestion entre comptes que pour les pipelines publics, pas pour les pipelines VPC.
Il se peut que vous deviez ingérer des données dans un pipeline à partir d'un autre compte Compte AWS, tel qu'un compte hébergeant votre application source. Si le principal qui écrit dans un pipeline se trouve dans un compte différent de celui du pipeline lui-même, vous devez configurer le principal pour qu'il fasse confiance à un autre rôle IAM pour ingérer des données dans le pipeline.
Pour configurer les autorisations d'ingestion entre comptes
-
Créez le rôle d'ingestion avec
osis:Ingestautorisation (décrit dans la section précédente) dans le même cadre Compte AWS que le pipeline. Pour obtenir des instructions, consultez la section Création de rôles IAM. -
Associez une politique de confiance au rôle d'ingestion qui permet à un mandant d'un autre compte de l'assumer :
-
Dans l'autre compte, configurez votre application cliente (par exemple, Fluent Bit) pour qu'elle assume le rôle d'ingestion. Pour que cela fonctionne, le compte de l'application doit autoriser l'utilisateur ou le rôle de l'application à assumer le rôle d'ingestion.
L'exemple de politique basée sur l'identité suivant permet au principal attaché d'assumer à
ingestion-rolepartir du compte de pipeline :
L'application cliente peut ensuite utiliser l'AssumeRoleopération pour prélever ingestion-role et ingérer des données dans le pipeline associé.
Étapes suivantes
Après avoir exporté vos données vers un pipeline, vous pouvez les interroger depuis le domaine de OpenSearch service configuré en tant que récepteur pour le pipeline. Les ressources suivantes peuvent vous aider à démarrer :
