Amazon Redshift tidak akan lagi mendukung penggunaan Python UDF setelah 30 Juni 2026. Kami akan mulai menegakkannya secara bertahap. Untuk informasi lebih lanjut tentang detail opsi akhir masa pakai dan migrasi Python, lihat posting blog
Terjemahan disediakan oleh mesin penerjemah. Jika konten terjemahan yang diberikan bertentangan dengan versi bahasa Inggris aslinya, utamakan versi bahasa Inggris.
Penyimpanan kolumnar
Bagian ini menjelaskan penyimpanan kolumnar, yang merupakan metode yang digunakan Amazon Redshift untuk menyimpan data tabular secara efisien.
Penyimpanan kolom untuk tabel database merupakan faktor penting dalam mengoptimalkan kinerja kueri analitik, karena secara drastis mengurangi I/O kebutuhan disk secara keseluruhan. Ini mengurangi jumlah data yang perlu Anda muat dari disk.
Rangkaian ilustrasi berikut menjelaskan bagaimana penyimpanan data kolumnar mengimplementasikan efisiensi, dan bagaimana hal itu diterjemahkan menjadi efisiensi saat mengambil data ke dalam memori.
Ilustrasi pertama ini menunjukkan bagaimana catatan dari tabel database biasanya disimpan ke dalam blok disk demi baris.
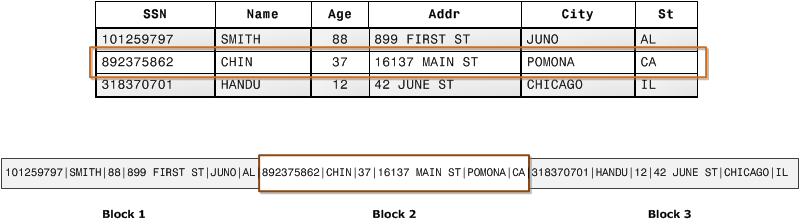
Dalam tabel database relasional tipikal, setiap baris berisi nilai bidang untuk satu catatan. Dalam penyimpanan database baris, blok data menyimpan nilai secara berurutan untuk setiap kolom berturut-turut yang membentuk seluruh baris. Jika ukuran blok lebih kecil dari ukuran catatan, penyimpanan untuk seluruh catatan mungkin membutuhkan lebih dari satu blok. Jika ukuran blok lebih besar dari ukuran catatan, penyimpanan untuk seluruh catatan mungkin memakan waktu kurang dari satu blok, yang mengakibatkan penggunaan ruang disk yang tidak efisien. Dalam aplikasi pemrosesan transaksi online (OLTP), sebagian besar transaksi melibatkan sering membaca dan menulis semua nilai untuk seluruh catatan, biasanya satu catatan atau sejumlah kecil catatan pada satu waktu. Akibatnya, penyimpanan baris optimal untuk database OLTP.
Ilustrasi berikutnya menunjukkan bagaimana dengan penyimpanan kolumnar, nilai untuk setiap kolom disimpan secara berurutan ke dalam blok disk.
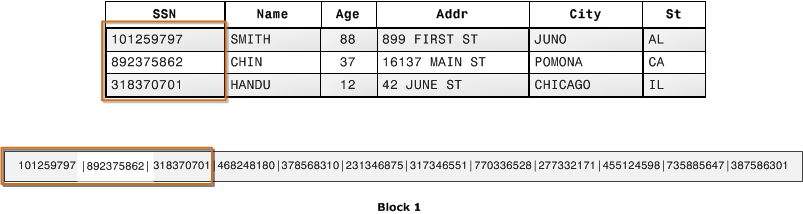
Menggunakan penyimpanan kolumnar, setiap blok data menyimpan nilai dari satu kolom untuk beberapa baris. Saat catatan masuk ke sistem, Amazon Redshift secara transparan mengonversi data ke penyimpanan kolom untuk setiap kolom.
Dalam contoh yang disederhanakan ini, menggunakan penyimpanan kolumnar, setiap blok data menyimpan nilai bidang kolom sebanyak tiga kali lebih banyak rekaman daripada penyimpanan berbasis baris. Ini berarti bahwa membaca jumlah nilai kolom yang sama untuk jumlah catatan yang sama memerlukan sepertiga I/O operasi dibandingkan dengan penyimpanan baris. Dalam praktiknya, menggunakan tabel dengan jumlah kolom yang sangat besar dan jumlah baris yang sangat besar, efisiensi penyimpanan bahkan lebih besar.
Keuntungan tambahan adalah bahwa, karena setiap blok menyimpan jenis data yang sama, data blok dapat menggunakan skema kompresi yang dipilih secara khusus untuk tipe data kolom, selanjutnya mengurangi ruang disk dan I/O. Untuk informasi selengkapnya tentang pengkodean kompresi berdasarkan tipe data, lihatPengkodean kompresi.
Penghematan ruang untuk menyimpan data pada disk juga dibawa ke pengambilan dan kemudian menyimpan data itu dalam memori. Karena banyak operasi database hanya perlu mengakses atau beroperasi pada satu atau sejumlah kecil kolom pada satu waktu, Anda dapat menghemat ruang memori dengan hanya mengambil blok untuk kolom yang sebenarnya Anda butuhkan untuk kueri. Di mana transaksi OLTP biasanya melibatkan sebagian besar atau semua kolom dalam satu baris untuk sejumlah kecil catatan, kueri gudang data biasanya hanya membaca beberapa kolom untuk sejumlah besar baris. Ini berarti bahwa membaca jumlah nilai bidang kolom yang sama untuk jumlah baris yang sama membutuhkan sebagian kecil dari I/O operasi. Ini menggunakan sebagian kecil dari memori yang akan diperlukan untuk memproses blok baris. Dalam praktiknya, menggunakan tabel dengan jumlah kolom yang sangat besar dan jumlah baris yang sangat besar, keuntungan efisiensi secara proporsional lebih besar. Misalnya, sebuah tabel berisi 100 kolom. Kueri yang menggunakan lima kolom hanya perlu membaca sekitar lima persen dari data yang terkandung dalam tabel. Penghematan ini diulang untuk kemungkinan miliaran atau bahkan triliunan catatan untuk database besar. Sebaliknya, database baris akan membaca blok yang berisi 95 kolom yang tidak diperlukan juga.
Ukuran blok database khas berkisar dari 2 KB hingga 32 KB. Amazon Redshift menggunakan ukuran blok 1 MB, yang lebih efisien dan selanjutnya mengurangi jumlah I/O permintaan yang diperlukan untuk melakukan pemuatan database atau operasi lain yang merupakan bagian dari menjalankan kueri.
