Terjemahan disediakan oleh mesin penerjemah. Jika konten terjemahan yang diberikan bertentangan dengan versi bahasa Inggris aslinya, utamakan versi bahasa Inggris.
# Dapatkan hasil pekerjaan rekomendasi inferensi Anda
Kumpulkan hasil pekerjaan rekomendasi inferensi Anda secara terprogram dengan AWS SDK untuk Python (Boto3), Studio Classic AWS CLI, atau konsol AI. SageMaker
------
#### [ AWS SDK untuk Python (Boto3) ]
Setelah rekomendasi inferensi selesai, Anda dapat menggunakannya `DescribeInferenceRecommendationsJob` untuk mendapatkan detail pekerjaan dan rekomendasi. Berikan nama pekerjaan yang Anda gunakan saat membuat pekerjaan rekomendasi inferensi.
```
job_name={{''}}
response = sagemaker_client.describe_inference_recommendations_job(
JobName=job_name)
```
Cetak objek respons. Sampel kode sebelumnya menyimpan respons dalam variabel bernama`response`.
```
print(response['Status'])
```
Ini mengembalikan respons JSON yang mirip dengan contoh berikut. Perhatikan bahwa contoh ini menunjukkan jenis instance yang direkomendasikan untuk inferensi real-time (untuk contoh yang menunjukkan rekomendasi inferensi tanpa server, lihat contoh setelah ini).
```
{
'JobName': {{'job-name'}},
'JobDescription': {{'job-description'}},
'JobType': 'Default',
'JobArn': 'arn:aws:sagemaker:{{region}}:{{account-id}}:inference-recommendations-job/{{resource-id}}',
'Status': 'COMPLETED',
'CreationTime': datetime.datetime(2021, 10, 26, 20, 4, 57, 627000, tzinfo=tzlocal()),
'LastModifiedTime': datetime.datetime(2021, 10, 26, 20, 25, 1, 997000, tzinfo=tzlocal()),
'InputConfig': {
'ModelPackageVersionArn': 'arn:aws:sagemaker:{{region}}:{{account-id}}:model-package/{{resource-id}}',
'JobDurationInSeconds': 0
},
'InferenceRecommendations': [{
'Metrics': {
'CostPerHour': 0.20399999618530273,
'CostPerInference': 5.246913588052848e-06,
'MaximumInvocations': 648,
'ModelLatency': 263596
},
'EndpointConfiguration': {
'EndpointName': {{'endpoint-name'}},
'VariantName': {{'variant-name'}},
'InstanceType': 'ml.c5.xlarge',
'InitialInstanceCount': 1
},
'ModelConfiguration': {
'Compiled': False,
'EnvironmentParameters': []
}
},
{
'Metrics': {
'CostPerHour': 0.11500000208616257,
'CostPerInference': 2.92620870823157e-06,
'MaximumInvocations': 655,
'ModelLatency': 826019
},
'EndpointConfiguration': {
'EndpointName': {{'endpoint-name'}},
'VariantName': {{'variant-name'}},
'InstanceType': 'ml.c5d.large',
'InitialInstanceCount': 1
},
'ModelConfiguration': {
'Compiled': False,
'EnvironmentParameters': []
}
},
{
'Metrics': {
'CostPerHour': 0.11500000208616257,
'CostPerInference': 3.3625731248321244e-06,
'MaximumInvocations': 570,
'ModelLatency': 1085446
},
'EndpointConfiguration': {
'EndpointName': {{'endpoint-name'}},
'VariantName': {{'variant-name'}},
'InstanceType': 'ml.m5.large',
'InitialInstanceCount': 1
},
'ModelConfiguration': {
'Compiled': False,
'EnvironmentParameters': []
}
}],
'ResponseMetadata': {
'RequestId': {{'request-id'}},
'HTTPStatusCode': 200,
'HTTPHeaders': {
'x-amzn-requestid': {{'x-amzn-requestid'}},
'content-type': {{'content-type'}},
'content-length': '1685',
'date': 'Tue, 26 Oct 2021 20:31:10 GMT'
},
'RetryAttempts': 0
}
}
```
Beberapa baris pertama memberikan informasi tentang pekerjaan rekomendasi inferensi itu sendiri. Ini termasuk nama pekerjaan, peran ARN, dan waktu pembuatan dan penghapusan.
Kam `InferenceRecommendations` us berisi daftar rekomendasi inferensi Inferensi Recommender.
Kam `EndpointConfiguration` us bersarang berisi rekomendasi instance type (`InstanceType`) bersama dengan titik akhir dan nama varian (model pembelajaran AWS mesin yang digunakan) yang digunakan selama pekerjaan rekomendasi. Anda dapat menggunakan titik akhir dan nama varian untuk pemantauan di Amazon Ev CloudWatch ents. Untuk informasi selengkapnya, lihat [Metrik SageMaker AI Amazon di Amazon CloudWatch](monitoring-cloudwatch.md).
Kam `Metrics` us bersarang berisi informasi tentang perkiraan biaya per jam (`CostPerHour`) untuk titik akhir real-time Anda dalam dolar AS, perkiraan biaya per inferensi (`CostPerInference`) dalam dolar AS untuk titik akhir real-time Anda, jumlah maksimum `InvokeEndpoint` permintaan per menit yang diharapkan dikirim ke titik akhir (`MaxInvocations`), dan latensi model (`ModelLatency`), yang merupakan interval waktu (dalam mikrodetik) yang diambil model Anda untuk merespons AI. SageMaker Latensi model mencakup waktu komunikasi lokal yang diperlukan untuk mengirim permintaan dan mengambil respons dari wadah model dan waktu yang dibutuhkan untuk menyelesaikan inferensi dalam wadah.
Contoh berikut menunjukkan `InferenceRecommendations` bagian respons untuk pekerjaan rekomendasi inferensi yang dikonfigurasi untuk mengembalikan rekomendasi inferensi tanpa server:
```
"InferenceRecommendations": [
{
"EndpointConfiguration": {
"EndpointName": "{{value}}",
"InitialInstanceCount": {{value}},
"InstanceType": "{{value}}",
"VariantName": "{{value}}",
"ServerlessConfig": {
"MaxConcurrency": {{value}},
"MemorySizeInMb": {{value}}
}
},
"InvocationEndTime": {{value}},
"InvocationStartTime": {{value}},
"Metrics": {
"CostPerHour": {{value}},
"CostPerInference": {{value}},
"CpuUtilization": {{value}},
"MaxInvocations": {{value}},
"MemoryUtilization": {{value}},
"ModelLatency": {{value}},
"ModelSetupTime": {{value}}
},
"ModelConfiguration": {
"Compiled": "False",
"EnvironmentParameters": [],
"InferenceSpecificationName": "{{value}}"
},
"RecommendationId": "{{value}}"
}
]
```
Anda dapat menafsirkan rekomendasi untuk inferensi tanpa server mirip dengan hasil untuk inferensi real-time, dengan pengecualian`ServerlessConfig`, yang memberi tahu Anda metrik yang dikembalikan untuk titik akhir tanpa server dengan yang diberikan dan kapan. `MemorySizeInMB` `MaxConcurrency = 1` Untuk meningkatkan throughput yang mungkin pada titik akhir, tingkatkan nilai `MaxConcurrency` linier. Misalnya, jika rekomendasi inferensi menunjukkan `MaxInvocations` sebagai`1000`, maka peningkatan `MaxConcurrency` menjadi `2` akan mendukung 2000`MaxInvocations`. Perhatikan bahwa ini benar hanya sampai titik tertentu, yang dapat bervariasi berdasarkan model dan kode Anda. Rekomendasi tanpa server juga mengukur metrik`ModelSetupTime`, yang mengukur (dalam mikrodetik) waktu yang dibutuhkan untuk meluncurkan sumber daya komputer pada titik akhir tanpa server. Untuk informasi selengkapnya tentang menyiapkan titik akhir tanpa server, lihat dokumentasi [ Serverless Inference. ](https://docs.aws.amazon.com/sagemaker/latest/dg/serverless-endpoints.html)
------
#### [ AWS CLI ]
Setelah rekomendasi inferensi selesai, Anda dapat menggunakannya `describe-inference-recommendations-job` untuk mendapatkan detail pekerjaan dan jenis instans yang direkomendasikan. Berikan nama pekerjaan yang Anda gunakan saat membuat pekerjaan rekomendasi inferensi.
```
aws sagemaker describe-inference-recommendations-job\
--job-name {{}}\
--region {{}}
```
Respons JSON serupa harus menyerupai contoh berikut. Perhatikan bahwa contoh ini menunjukkan jenis instance yang direkomendasikan untuk inferensi real-time (untuk contoh yang menunjukkan rekomendasi inferensi tanpa server, lihat contoh setelah ini).
```
{
'JobName': {{'job-name'}},
'JobDescription': {{'job-description'}},
'JobType': 'Default',
'JobArn': 'arn:aws:sagemaker:{{region}}:{{account-id}}:inference-recommendations-job/{{resource-id}}',
'Status': 'COMPLETED',
'CreationTime': datetime.datetime(2021, 10, 26, 20, 4, 57, 627000, tzinfo=tzlocal()),
'LastModifiedTime': datetime.datetime(2021, 10, 26, 20, 25, 1, 997000, tzinfo=tzlocal()),
'InputConfig': {
'ModelPackageVersionArn': 'arn:aws:sagemaker:{{region}}:{{account-id}}:model-package/{{resource-id}}',
'JobDurationInSeconds': 0
},
'InferenceRecommendations': [{
'Metrics': {
'CostPerHour': 0.20399999618530273,
'CostPerInference': 5.246913588052848e-06,
'MaximumInvocations': 648,
'ModelLatency': 263596
},
'EndpointConfiguration': {
'EndpointName': {{'endpoint-name'}},
'VariantName': {{'variant-name'}},
'InstanceType': 'ml.c5.xlarge',
'InitialInstanceCount': 1
},
'ModelConfiguration': {
'Compiled': False,
'EnvironmentParameters': []
}
},
{
'Metrics': {
'CostPerHour': 0.11500000208616257,
'CostPerInference': 2.92620870823157e-06,
'MaximumInvocations': 655,
'ModelLatency': 826019
},
'EndpointConfiguration': {
'EndpointName': {{'endpoint-name'}},
'VariantName': {{'variant-name'}},
'InstanceType': 'ml.c5d.large',
'InitialInstanceCount': 1
},
'ModelConfiguration': {
'Compiled': False,
'EnvironmentParameters': []
}
},
{
'Metrics': {
'CostPerHour': 0.11500000208616257,
'CostPerInference': 3.3625731248321244e-06,
'MaximumInvocations': 570,
'ModelLatency': 1085446
},
'EndpointConfiguration': {
'EndpointName': {{'endpoint-name'}},
'VariantName': {{'variant-name'}},
'InstanceType': 'ml.m5.large',
'InitialInstanceCount': 1
},
'ModelConfiguration': {
'Compiled': False,
'EnvironmentParameters': []
}
}],
'ResponseMetadata': {
'RequestId': {{'request-id'}},
'HTTPStatusCode': 200,
'HTTPHeaders': {
'x-amzn-requestid': {{'x-amzn-requestid'}},
'content-type': {{'content-type'}},
'content-length': '1685',
'date': 'Tue, 26 Oct 2021 20:31:10 GMT'
},
'RetryAttempts': 0
}
}
```
Beberapa baris pertama memberikan informasi tentang pekerjaan rekomendasi inferensi itu sendiri. Ini termasuk nama pekerjaan, peran ARN, pembuatan, dan waktu penghapusan.
Kam `InferenceRecommendations` us berisi daftar rekomendasi inferensi Inferensi Recommender.
Kam `EndpointConfiguration` us bersarang berisi rekomendasi instance type (`InstanceType`) bersama dengan titik akhir dan nama varian (model pembelajaran AWS mesin yang digunakan) yang digunakan selama pekerjaan rekomendasi. Anda dapat menggunakan titik akhir dan nama varian untuk pemantauan di Amazon Ev CloudWatch ents. Untuk informasi selengkapnya, lihat [Metrik SageMaker AI Amazon di Amazon CloudWatch](monitoring-cloudwatch.md).
Kam `Metrics` us bersarang berisi informasi tentang perkiraan biaya per jam (`CostPerHour`) untuk titik akhir real-time Anda dalam dolar AS, perkiraan biaya per inferensi (`CostPerInference`) dalam dolar AS untuk titik akhir real-time Anda, jumlah maksimum `InvokeEndpoint` permintaan per menit yang diharapkan dikirim ke titik akhir (`MaxInvocations`), dan latensi model (`ModelLatency`), yang merupakan interval waktu (dalam milidetik) yang diambil model Anda untuk merespons AI. SageMaker Latensi model mencakup waktu komunikasi lokal yang diperlukan untuk mengirim permintaan dan mengambil respons dari wadah model dan waktu yang dibutuhkan untuk menyelesaikan inferensi dalam wadah.
Contoh berikut menunjukkan `InferenceRecommendations` bagian respons untuk pekerjaan rekomendasi inferensi yang dikonfigurasi untuk mengembalikan rekomendasi inferensi tanpa server:
```
"InferenceRecommendations": [
{
"EndpointConfiguration": {
"EndpointName": "{{value}}",
"InitialInstanceCount": {{value}},
"InstanceType": "{{value}}",
"VariantName": "{{value}}",
"ServerlessConfig": {
"MaxConcurrency": {{value}},
"MemorySizeInMb": {{value}}
}
},
"InvocationEndTime": {{value}},
"InvocationStartTime": {{value}},
"Metrics": {
"CostPerHour": {{value}},
"CostPerInference": {{value}},
"CpuUtilization": {{value}},
"MaxInvocations": {{value}},
"MemoryUtilization": {{value}},
"ModelLatency": {{value}},
"ModelSetupTime": {{value}}
},
"ModelConfiguration": {
"Compiled": "False",
"EnvironmentParameters": [],
"InferenceSpecificationName": "{{value}}"
},
"RecommendationId": "{{value}}"
}
]
```
Anda dapat menafsirkan rekomendasi untuk inferensi tanpa server mirip dengan hasil untuk inferensi real-time, dengan pengecualian`ServerlessConfig`, yang memberi tahu Anda metrik yang dikembalikan untuk titik akhir tanpa server dengan yang diberikan dan kapan. `MemorySizeInMB` `MaxConcurrency = 1` Untuk meningkatkan throughput yang mungkin pada titik akhir, tingkatkan nilai `MaxConcurrency` linier. Misalnya, jika rekomendasi inferensi menunjukkan `MaxInvocations` sebagai`1000`, maka peningkatan `MaxConcurrency` menjadi `2` akan mendukung 2000`MaxInvocations`. Perhatikan bahwa ini benar hanya sampai titik tertentu, yang dapat bervariasi berdasarkan model dan kode Anda. Rekomendasi tanpa server juga mengukur metrik`ModelSetupTime`, yang mengukur (dalam mikrodetik) waktu yang dibutuhkan untuk meluncurkan sumber daya komputer pada titik akhir tanpa server. Untuk informasi selengkapnya tentang menyiapkan titik akhir tanpa server, lihat dokumentasi [ Serverless Inference. ](https://docs.aws.amazon.com/sagemaker/latest/dg/serverless-endpoints.html)
------
#### [ Amazon SageMaker Studio Classic ]
Rekomendasi inferensi diisi di ** tab Rekomendasi ** Inferensi baru dalam Studio Classic. Diperlukan waktu hingga 45 menit agar hasilnya muncul. Tab ini berisi judul ** kolom ** Hasil ** dan ** Detail.
**Kolom ** Detail memberikan informasi tentang pekerjaan rekomendasi inferensi, seperti nama rekomendasi inferensi, kapan pekerjaan dibuat (Waktu ** pembuatan**), dan banyak lagi. Ini juga menyediakan ** informasi Peng ** aturan, seperti jumlah maksimum pemanggilan yang terjadi per menit dan informasi tentang Nama Sumber Daya Amazon yang digunakan.
**Kolom ** Hasil menyediakan ** ** jendela Tujuan ** Pener ** SageMaker apan dan rekomendasi AI di mana Anda dapat menyesuaikan urutan tampilan hasil berdasarkan kepentingan penerapan. Ada tiga menu dropdown yang dapat Anda gunakan untuk memberikan tingkat kepentingan ** Biaya**, ** Latensi**, dan Th ** roughput ** untuk kasus penggunaan Anda. Untuk setiap sasaran (biaya, latensi, dan throughput), Anda dapat mengatur tingkat kepentingan: Kepentingan Ter ** endah, Kepentingan R ** endah**, Kepent ** ingan ** sedang**, Kepent ** ingan tinggi**, atau Kep ** entingan tertinggi**.
Berdasarkan pilihan penting Anda untuk setiap tujuan, Inference Recommender menampilkan rekomendasi utamanya di ** bidang ** SageMaker rekomendasi di sebelah kanan panel, bersama dengan perkiraan biaya per jam dan permintaan inferensi. Ini juga memberikan informasi tentang latensi model yang diharapkan, jumlah maksimum pemanggilan, dan jumlah instance. Untuk rekomendasi tanpa server, Anda dapat melihat nilai ideal untuk konkurensi maksimum dan ukuran memori titik akhir.
Selain rekomendasi teratas yang ditampilkan, Anda juga dapat melihat informasi yang sama ditampilkan untuk semua contoh yang diuji Inferensi Recommender di bagian ** Semua proses. **
------
#### [ SageMaker AI console ]
Anda dapat melihat pekerjaan rekomendasi instans di konsol SageMaker AI dengan melakukan hal berikut:
1. Buka konsol SageMaker AI di [ https://console.aws.amazon.com/sagemaker/](https://console.aws.amazon.com/sagemaker/).
1. Di panel navigasi kiri, pilih ** Inferensi**, lalu pilih ** Inferensi rekomendator. **
1. Pada ** halaman pekerjaan ** rekomendasi inferensi, pilih nama pekerjaan rekomendasi inferensi Anda.
Pada halaman detail untuk pekerjaan Anda, Anda dapat melihat rekomendasi ** inferensi**, yang merupakan jenis instans yang direkomendasikan SageMaker AI untuk model Anda, seperti yang ditunjukkan pada tangkapan layar berikut.
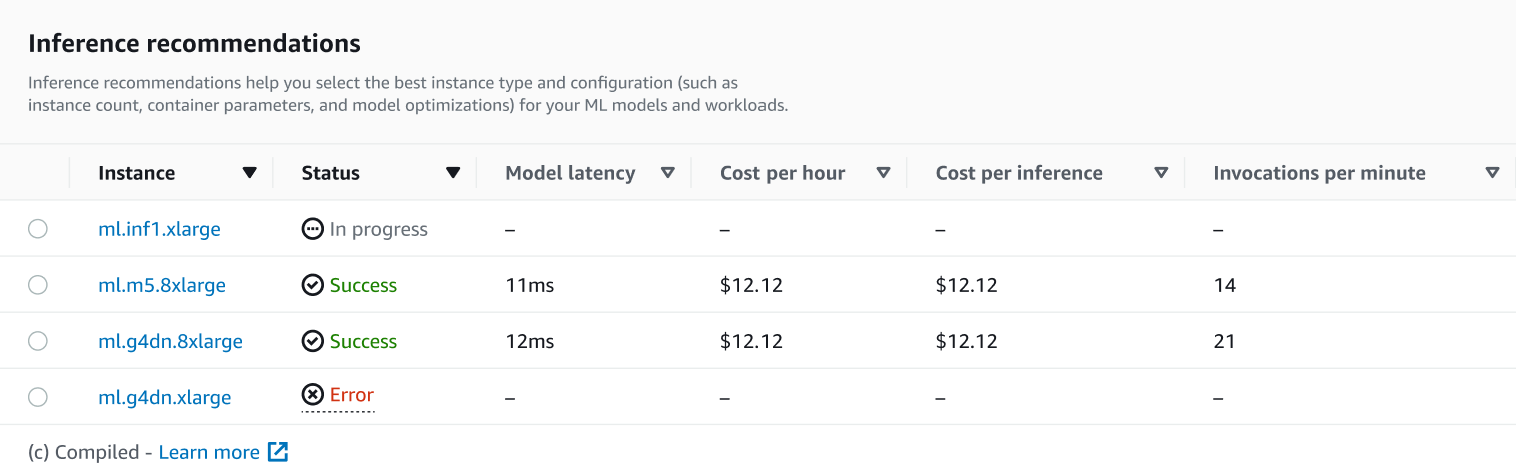
Di bagian ini, Anda dapat membandingkan jenis instans berdasarkan berbagai faktor seperti latensi ** Model**, ** Biaya per jam**, ** Biaya per inferensi**, dan Pemanggilan per ** menit. **
Di halaman ini, Anda juga dapat melihat konfigurasi yang Anda tentukan untuk pekerjaan Anda. Di ** bagian ** Monitor, Anda dapat melihat CloudWatch metrik Amazon yang dicatat untuk setiap jenis instans. Untuk mempelajari lebih lanjut tentang menafsirkan metrik ini, lihat Men [ afsirkan hasil](https://docs.aws.amazon.com/sagemaker/latest/dg/inference-recommender-interpret-results.html).
------
Untuk informasi selengkapnya tentang menafsirkan hasil pekerjaan rekomendasi Anda, lihat[Hasil rekomendasi](inference-recommender-interpret-results.md).