O Amazon Forecast não está mais disponível para novos clientes. Os clientes existentes do Amazon Forecast podem continuar usando o serviço normalmente. [Saiba mais](https://aws.amazon.com/blogs/machine-learning/transition-your-amazon-forecast-usage-to-amazon-sagemaker-canvas/)
As traduções são geradas por tradução automática. Em caso de conflito entre o conteúdo da tradução e da versão original em inglês, a versão em inglês prevalecerá.
# Importação de conjuntos de dados
Os *conjuntos de dados* contêm os dados usados para treinar um [preditor](howitworks-predictor.md). Crie um ou mais conjuntos de dados do Amazon Forecast e importe os dados de treinamento para eles. Um *grupo de conjuntos de dados* é uma coleção de conjuntos de dados complementares que detalham um conjunto de alterações de parâmetros ao longo de uma série temporal. Depois de criar um grupo de conjuntos de dados, você o usará para treinar um preditor.
Cada grupo de conjuntos de dados pode ter até três conjuntos de dados, um de cada tipo de [conjunto de dados](#howitworks-dataset-domainstypes): séries temporais de destino, séries temporais relacionadas e metadados de itens.
Para criar e gerenciar conjuntos de dados e grupos de conjuntos de dados do Forecast, você pode usar o console, AWS Command Line Interface (AWS CLI) ou AWS o SDK do Forecast.
Por exemplo, conjuntos de dados de previsão, consulte o GitHub repositório [https://github.com/aws-samples/amazon-forecast-samples](https://github.com/aws-samples/amazon-forecast-samples) Amazon Forecast Sample.
**Topics**
+ [Conjuntos de dados](#howitworks-dataset)
+ [Grupos de conjuntos de dados](#howitworks-datasetgroup)
+ [Resolver conflitos na frequência da coleta de dados](#howitworks-data-alignment)
+ [Usar conjuntos de dados de séries temporais relacionadas](related-time-series-datasets.md)
+ [Uso de conjuntos de dados de metadados de itens](item-metadata-datasets.md)
+ [Domínios e tipos de conjunto de dados predefinidos](howitworks-domains-ds-types.md)
+ [Atualização de dados](updating-data.md)
+ [Lidar com valores ausentes](howitworks-missing-values.md)
+ [Diretrizes de conjuntos de dados do Forecast](dataset-import-guidelines-troubleshooting.md)
## Conjuntos de dados
Para criar e gerenciar os conjuntos de dados do Forecast, você pode usar as APIs do Forecast, incluindo as operações [CreateDataset](API_CreateDataset.md) e [DescribeDataset](API_DescribeDataset.md). Para obter uma lista completa de APIs do Forecast, consulte [Referência da API](api-reference.md).
Ao criar um conjunto de dados, você fornece informações, como as seguintes:
+ O frequency/interval local em que você registrou seus dados. Por exemplo, você pode agregar e registrar vendas de itens de varejo toda semana. No exercício [Conceitos básicos](getting-started.md), use a eletricidade média usada por hora.
+ O formato de previsão (o *domínio*) e o tipo de conjunto de dados (dentro do domínio). Um domínio de conjunto de dados especifica qual tipo de previsão você gostaria de realizar, enquanto um tipo de conjunto de dados ajuda você a organizar seus dados de treinamento em categorias. Forecast-friendly
+ O *esquema* do conjunto de dados. Um esquema mapeia os cabeçalhos da coluna do conjunto de dados. Por exemplo, ao monitorar a demanda, você pode ter coletado dados por hora sobre as vendas de um item em várias lojas. Nesse caso, o esquema define a ordem, da esquerda para a direita, em que o time stamp, o local e as vendas por hora aparecem no arquivo de dados de treinamento. Os esquemas também definem o tipo de dados de cada coluna, como `string` ou `integer`.
+ Informações sobre geolocalização e fuso horário. O atributo de geolocalização é definido no esquema com o tipo de atributo `geolocation`. As informações de fuso horário são definidas com a [ CreateDatasetImportJob ](API_CreateDatasetImportJob.md) operação. Os dados de geolocalização e fuso horário devem ser incluídos para habilitar o [Weather Index](weather.md).
Cada coluna no conjunto de dados do Forecast representa uma *dimension* ou *feature* da previsão. As dimensões de previsão descrevem os aspectos dos dados que não mudam ao longo do tempo, tal como `store` ou `location`. Os recursos de previsão incluem qualquer parâmetro em nos dados que variam ao longo do tempo, como `price` ou `promotion`. Algumas dimensões, como `timestamp` ou `itemId`, são necessárias em conjuntos de dados de séries temporais de destino e de séries temporais relacionadas.
### Domínios e tipos de conjunto de dados
Ao criar um conjunto de dados do Forecast, você escolhe um domínio e um tipo de conjunto de dados. O Forecast fornece domínios para vários casos de uso, como previsão de demanda de varejo ou tráfego da web. Também é possível criar um domínio personalizado. Para obter uma lista completa de domínios do Forecast, consulte [Domínios e tipos de conjunto de dados predefinidos](howitworks-domains-ds-types.md).
Em cada domínio, os usuários do Forecast podem especificar os seguintes tipos de conjuntos de dados:
+ Conjunto de dados de séries temporais de destino (obrigatório): use este tipo de conjunto de dados quando os dados de treinamento forem uma série temporal *e* eles incluírem o campo para o qual você deseja gerar uma previsão. Esse campo é chamado de *campo de destino*.
+ Conjunto de dados de séries temporais relacionadas (opcional): escolha este tipo de conjunto de dados quando os dados de treinamento forem uma série temporal, mas *não* incluírem o campo de destino. Por exemplo, se você estiver prevendo a demanda de itens, um conjunto de dados de séries temporais relacionadas pode ter `price` como um campo, mas não `demand`.
+ Conjunto de dados de metadados de itens (opcional): escolha este tipo de conjunto de dados quando os dados de treinamento *não* forem dados de séries temporais, mas incluírem informações de metadados sobre os itens nos conjuntos de dados de séries temporais de destino ou relacionadas. Por exemplo, se você estiver prevendo a demanda do item, um conjunto de dados de metadados de itens pode ter `color` ou `brand` como dimensões.
O Forecast considera apenas os dados fornecidos por um tipo de conjunto de dados de metadados do item quando você usa o algoritmo [ CNN-QR ](aws-forecast-algo-cnnqr.md) ou [ Algoritmo DeepAR\+DeepAR\+ Use o algoritmo DeepAR\+ do Amazon Forecast para previsões de séries temporais quando o conjunto de dados contém centenas de séries temporais de recursos. O Amazon Forecast DeepAr\+ é um algoritmo de aprendizado supervisionado para prever séries temporais escalares (unidimensionais) usando redes neurais recorrentes (). RNNs Os métodos de previsão clássicos, como o Média móvel integrada autorregressiva (ARIMA - Autoregressive integrated moving average) ou o Suavização exponencial (ETS - Exponential smoothing), adequam um único modelo a cada série temporal e usam esse modelo para extrapolar as séries temporais para o futuro. Em muitas aplicações, no entanto, você pode ter muitas séries temporais semelhantes em um conjunto de unidades transversais. Esses agrupamentos de série temporal exigem diferentes produtos, cargas de servidor e solicitações de páginas da web. Nesse caso, pode ser útil treinar um modelo único conjuntamente sobre todas essas séries temporais. A DeepAR\+ usa essa abordagem. Quando o conjunto de dados contém centenas de recursos de série temporal, o algoritmo DeepAR\+ supera os métodos padrão ARIMA e ETS. Você também pode usar o modelo treinado para gerar previsões para novas séries temporais que são semelhantes às que você já treinou. Cadernos PythonPara obter um step-by-step guia sobre como usar o algoritmo DeepAr\+, consulte [Introdução](https://github.com/aws-samples/amazon-forecast-samples/blob/master/notebooks/advanced/Getting_started_with_DeepAR%2B/Getting_started_with_DeepAR%2B.ipynb) ao DeepAr\+. Como funciona o DeepAR\+Como funciona Saiba como funciona o algoritmo DeepAR\+do Amazon Forecast. Durante o treinamento, a DeepAR\+ usa um conjunto de dados de treinamento e um conjunto de dados de teste opcional. Ela usa o conjunto de dados de teste para avaliar o modelo treinado. Em geral, os conjuntos de dados de treinamento e de teste não precisam conter o mesmo conjunto de série temporal. Você pode usar um modelo treinado em um determinado conjunto de treinamento para gerar previsões para o futuro da série temporal nesse conjunto de treinamento e para outras séries temporais. Os conjuntos de dados de treinamento e de teste consistem em séries temporais de destino (de preferência, mais de uma). *Opcionalmente, eles podem ser associados a um vetor de séries temporais de recursos e a um vetor de recursos categóricos (para obter detalhes, consulte [DeepAR Input/Output Interface](https://docs.aws.amazon.com/sagemaker/latest/dg/deepar.html#deepar-inputoutput) no AI Developer Guide). SageMaker * O exemplo a seguir mostra como isso funciona para um elemento de um conjunto de dados de treinamento indexado por `i`. O conjunto de dados de treinamento consiste em uma série temporal de destino, `zi,t`, e duas séries temporais de recursos associadas, `xi,1,t` e `xi,2,t`.

A série temporal de destino pode conter valores ausentes (indicados nos gráficos por quebras na série temporal). A DeepAR\+ é compatível apenas com séries temporais de recursos que são conhecidas no futuro. Isso permite que você execute situações "e se" contrafatuais. Por exemplo, "O que acontecerá se eu alterar o preço de um produto de alguma forma?" Cada série temporal de destino também pode ser associada a vários atributos categóricos. Você pode usar esses para codificar que uma série temporal pertence a determinados agrupamentos. O uso de recursos categóricos permite que o modelo aprenda o comportamento típico para esses agrupamentos, o que pode aumentar a precisão. Um modelo implementa isso aprendendo um vetor de incorporação para cada grupo que captura as propriedades comuns a todas as séries temporais do grupo. Para facilitar os padrões dependentes de tempo, como picos durante fins de semana, a DeepAR\+ cria séries temporais de recursos automaticamente com base na granularidade da série temporal. Por exemplo, a DeepAR\+ cria duas séries temporais de recursos (dia do mês e dia do ano) em uma série temporal semanal. Ela usa essas séries temporais de recursos derivados junto com a série temporal de recursos personalizada que você fornece durante o treinamento e a inferência. O exemplo a seguir mostra dois recursos de série temporal derivada: `ui,1,t` representa a hora do dia, e `ui,2,t`, o dia da semana.
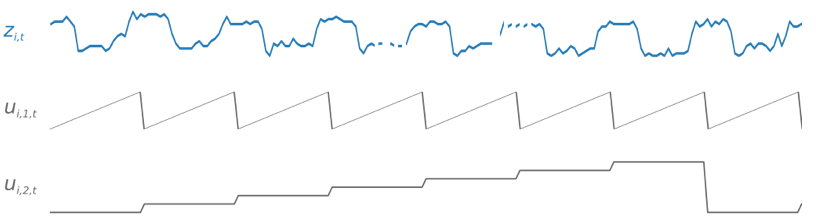
A DeepAR\+ inclui essa série temporal de recursos automaticamente com base na frequência e no tamanho dos dados de treinamento. A tabela a seguir lista os recursos que podem ser derivados para cada frequência básica de tempo com suporte.
| Frequência da série temporal | Atributos derivados |
| --- | --- |
| Minuto | minute-of-hour, hour-of-day, day-of-week, day-of-month, day-of-year |
| Hora | hour-of-day, day-of-week, day-of-month, day-of-year |
| Dia | day-of-week, day-of-month, day-of-year |
| Semana | week-of-month, week-of-year |
| Mês | month-of-year | Um modelo de DeepAR\+ é treinado por amostragem aleatória de vários exemplos de treinamento em cada uma das séries temporais no conjunto de dados de treinamento. Cada exemplo de treinamento consiste em um par de janelas de predição e contexto adjacentes com comprimentos predefinidos fixos. O hiperparâmetro `context_length` controla até que ponto no passado a rede pode ver, e o parâmetro `ForecastHorizon` controla até que ponto no futuro as previsões podem ser feitas. Durante o treinamento, o Amazon Forecast ignora elementos no conjunto de dados de treinamento com séries temporais menores que a duração da previsão especificada. O exemplo a seguir mostra cinco amostras, com uma duração de contexto (realçada em verde) de 12 horas e uma duração de previsão (realçada em azul) de 6 horas, extraídas do elemento `i`. Para resumir, excluímos as séries temporais de recursos `xi,1,t` e `ui,2,t`.
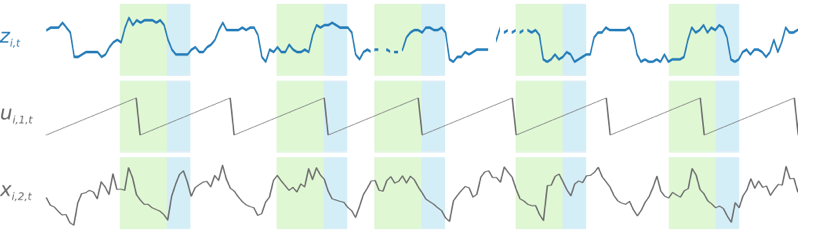
Para capturar padrões de sazonalidade, o DeepAR\+ também alimenta valores com atraso (período anterior) automaticamente da série temporal de destino. Em nosso exemplo com amostras tomadas em uma frequência por hora, para cada índice de tempo `t = T`, o modelo expõe os valores `zi,t`, que ocorreram há aproximadamente um, dois e três dias no passado (destacados em rosa).

Para inferência, o modelo treinado usa como entrada a série temporal de destino, que pode ou não ter sido usada durante o treinamento, e prevê uma distribuição de probabilidades para os próximos valores de `ForecastHorizon`. Como a DeepAR\+ é treinada em todo o conjunto de dados, a previsão considera os padrões aprendidos de séries temporais semelhantes. Para obter informações sobre a matemática por trás da DeepAR\+, consulte o artigo [DeepAR: Probabilistic Forecasting with Autoregressive Recurrent Networks](https://arxiv.org/abs/1704.04110) no site da Cornell University Library. Hiperparâmetros do DeepAR\+Hiperparâmetros A tabela a seguir lista os hiperparâmetros que podem ser usados no algoritmo DeepAR\+. Os parâmetros em negrito participam da otimização de hiperparâmetros (HPO).
| Nome do parâmetro | Description |
| --- | --- |
| context\_length | O número de pontos no tempo em que o modelo lê antes de fazer a previsão. O valor desse parâmetro deve ser o mesmo que o de `ForecastHorizon`. O modelo também recebe entradas defasadas do destino, portanto, `context_length` pode ser bem menor que as sazonalidades típicas. Por exemplo, uma série temporal diária pode ter sazonalidade anual. O modelo inclui automaticamente um atraso de um ano, para que a extensão de contexto possa ser menor que um ano. Os valores de atraso que o modelo seleciona dependem da frequência das séries temporais. Por exemplo, os valores defasados de frequência diária são: semana anterior, 2 semanas, 3 semanas, 4 semanas e ano.**Valores válidos**
Inteiros positivos
**Valores típicos**
ceil(0,1 \* `ForecastHorizon`) a min(200, 10 \* `ForecastHorizon`)
**Valor padrão **
2 \* `ForecastHorizon` |
| epochs | O número máximo de passagens para examinar os dados de treinamento. O valor ideal depende do tamanho dos dados e da taxa de aprendizado. Conjuntos de dados menores e taxas de aprendizagem mais baixas exigem mais epochs para alcançar bons resultados.**Valores válidos**
Inteiros positivos
**Valores típicos**
10 a 1000
**Valor padrão**
500 |
| learning\_rate | A taxa de aprendizado usada no treinamento.**Valores válidos**
Os números positivos de ponto flutuante
**Valores típicos**
0,0001 a 0,1
**Valor padrão**
0.001 |
| learning\_rate\_decay | A taxa na qual a taxa de aprendizagem diminui. No máximo, a taxa de aprendizagem é reduzida `max_learning_rate_decays` vezes e o treinamento é interrompido. Este parâmetro será usado somente se `max_learning_rate_decays` for maior que 0.**Valores válidos**
Os números positivos de ponto flutuante
**Valores típicos**
0,5 a 0,8 (inclusive)
**Valor padrão**
0,5 |
| likelihood | O modelo gera uma previsão probabilística e pode fornecer quantis da distribuição e retornar amostras. Dependendo de seus dados, escolha uma probabilidade (modelo de ruído) apropriada usada para estimativas de incerteza.
Valores válidos+ `beta`: use para destinos de valor real entre 0 e 1, inclusive.
+ `deterministic-L1`: uma função de perda que não estima incerteza e apenas aprende uma previsão pontual.
+ `gaussian`: use para dados de valor real.
+ `negative-binomial`: use para dados de contagem (inteiros não negativos).
+ `piecewise-linear`: use para distribuições flexíveis.
+ `student-T`: use essa alternativa para dados de valor real para dados intermitentes. **Valor padrão **
`student-T` |
| max\_learning\_rate\_decays | O número máximo de reduções da taxa de aprendizagem que devem ocorrer.**Valores válidos**
Inteiros positivos
**Valores típicos**
0 – 10
**Valor padrão**
0 |
| num\_averaged\_models | Na DeepAR\+, a trajetória de treinamento pode encontrar vários modelos. Cada modelo pode ter diferentes pontos fortes e fracos de previsão. A DeepAR\+ pode calcular a média dos comportamentos do modelo para aproveitar os pontos fortes de todos os modelos.**Valores válidos**
Inteiros positivos
**Valores típicos**
1 a 5 (inclusive)
**Valor padrão**
1 |
| num\_cells | O número de células a ser usado em cada camada oculta da RNN.**Valores válidos**
Inteiros positivos
**Valores típicos**
30 a 100
**Valor padrão**
40 |
| num\_layers | O número de camadas ocultas na RNN.**Valores válidos**
Inteiros positivos
**Valores típicos**
1 a 4
**Valor padrão**
2 | Ajustar modelos de DeepAR\+Ajuste de modelos Saiba como ajustar modelos do DeepAR\+. Para ajustar modelos do DeepAR\+ do Amazon Forecast, siga estas recomendações para otimizar o processo de treinamento e a configuração do hardware. Melhores práticas para otimização de processosPráticas recomendadas Práticas recomendadas para usar o algoritmo DeepAR\+ do Amazon Forecast. Para obter os melhores resultados, siga estas recomendações: Exceto ao dividir os conjuntos de dados de treinamento e teste, sempre forneça toda a série temporal para treinamento e teste e ao chamar o modelo para inferência. Independentemente de como você definir `context_length`, não divida séries temporais ou forneça apenas parte delas. O modelo usará pontos de dados mais anteriores do que `context_length` para os valores de recursos defasados. Para ajustar o modelo, você pode dividir o conjunto de dados em conjuntos de dados de treinamento e teste. Em um cenário de avaliação típico, você deve testar o modelo na mesma série temporal usada no treinamento, mas nos pontos temporais `ForecastHorizon` futuros imediatamente após o último ponto temporal visível durante o treinamento. Para criar conjuntos de dados de treinamento e teste que satisfaçam esses critérios, use o conjunto de dados inteiro (toda a série temporal) como um conjunto de dados de teste e remova os últimos pontos `ForecastHorizon` de cada série temporal para treinamento. Dessa forma, durante o treinamento, o modelo não vê os valores de destino de pontos temporais nos quais ele é avaliado durante o teste. Na fase de teste, os últimos pontos `ForecastHorizon` de cada série temporal no conjunto de dados de teste são retidos, e uma previsão é gerada. A previsão é então comparada com os valores reais dos últimos pontos `ForecastHorizon`. Você pode criar avaliações mais complexas repetindo séries temporais várias vezes no conjunto de dados de teste, mas isolando-as em diferentes pontos finais. Isso produz métricas de precisão médias que são calculadas ao longo de várias previsões de diferentes pontos temporais. Evite usar valores muito grandes (> 400) para o `ForecastHorizon`, pois isso torna o modelo lento e menos preciso. Para prever mais adiante no futuro, considere a agregação para uma frequência mais alta. Por exemplo, use `5min` em vez de `1min`. Devido às defasagens, o modelo pode olhar mais para trás no tempo além de `context_length`. Portanto, você não precisa definir esse parâmetro como um valor grande. Um bom ponto de partida para esse parâmetro é o mesmo valor que o de `ForecastHorizon`. Treine os modelos DeepAR\+ com quantas séries temporais estiverem disponíveis. Embora um modelo de DeepAR\+ treinado em uma única série temporal possa funcionar bem, métodos de previsão padrão, como ARIMA ou ETS, podem ser mais precisos e são mais personalizados para este caso de uso. A DeepAR\+ começa a superar os métodos padrão quando o conjunto de dados contém centenas de séries temporais de recursos. Atualmente, a DeepAR\+ requer que o número total de observações disponíveis em todas as séries temporais de treinamento seja, pelo menos, 300. ](aws-forecast-recipe-deeparplus.md) DeepAr\+.
Os metadados de itens são especialmente úteis em cenários de previsão coldstart, nos quais você tem poucos dados históricos diretos com os quais fazer previsões, mas tem dados históricos em itens com atributos de metadados semelhantes. Quando você inclui metadados de itens, o Forecast cria previsões coldstart com base em séries temporais semelhantes, o que pode criar uma previsão mais precisa.
Dependendo das informações nos dados de treinamento e do que você deseja prever, é possível criar mais de um conjunto de dados.
Por exemplo, suponha que você deseja gerar uma previsão para a demanda de itens de varejo, como sapatos e meias. Você pode criar os seguintes conjuntos de dados no domínio RETAIL:
+ Conjunto de dados de séries temporais de destino: inclui os dados históricos de demanda de séries temporais para os itens de varejo (`item_id`, `timestamp` e o campo de destino `demand`). Como ele designa o campo de destino que você deseja prever, é necessário ter pelo menos um conjunto de dados de séries temporais de destino em um grupo de conjuntos de dados.
Também é possível adicionar até dez outras dimensões a um conjunto de dados de séries temporais de destino. Se você incluir somente um conjunto de dados de séries temporais de destino no grupo de conjuntos de dados, poderá criar previsões no nível do item ou somente no nível de granularidade da dimensão da previsão. Para obter mais informações, consulte [CreatePredictor](API_CreatePredictor.md).
+ Conjunto de dados de séries temporais relacionadas: inclui dados históricos de séries temporais diferentes do campo de destino, como `price` ou `revenue`. Como os dados de séries temporais relacionadas devem ser mapeáveis para os dados de séries temporais de destino, cada conjunto de dados de séries temporais relacionadas deve conter os mesmos campos de identificação. No domínio RETAIL, eles seriam `item_id` e `timestamp`.
Um conjunto de dados de séries temporais relacionadas pode conter dados que refinam as previsões feitas com base no conjunto de dados de séries temporais de destino. Por exemplo, você pode incluir dados `price` no conjunto de dados de séries temporais relacionadas nas datas futuras para as quais deseja gerar uma previsão. Desta forma, o Forecast pode fazer previsões com uma dimensão adicional de contexto. Para obter mais informações, consulte [Usar conjuntos de dados de séries temporais relacionadas](related-time-series-datasets.md).
+ Conjunto de dados de metadados de itens: inclui metadados para os itens de varejo. Outros exemplos de metadados incluem `brand`, `category`, `color` e `genre`.
**Exemplo de conjunto de dados com uma dimensão de previsão**
Dando continuidade ao exemplo anterior, imagine que você deseja prever a demanda por sapatos e meias com base nas vendas anteriores de uma loja. No conjunto de dados de séries temporais de destino a seguir, `store` é uma dimensão de previsão de série temporal, enquanto `demand` é o campo de destino. As meias são vendidas em duas localizações de loja (NYC e SFO), e os sapatos são vendidos somente em ORD.
As três primeiras linhas dessa tabela contêm os primeiros dados de vendas disponíveis para as lojas de NYC, SFO e ORD. As últimas três linhas contêm os últimos dados de vendas registrados para cada loja. A linha `...` representa todos os dados de vendas de itens registrados entre a primeira e a última entradas.
timestamp | item_id | store | demand |
|---|
2019-01-01 | socks | NYC | 25 |
2019-01-05 | socks | SFO | 45 |
2019-02-01 | shoes | ORD | 10 |
... |
2019-06-01 | socks | NYC | 100 |
2019-06-05 | socks | SFO | 5 |
2019-07-01 | shoes | ORD | 50 |
### Esquema do conjunto de dados
Cada conjunto de dados requer um esquema, um mapeamento JSON fornecido pelo usuário dos campos nos dados de treinamento. É aqui que você lista as dimensões e os recursos obrigatórios e opcionais que deseja incluir no conjunto de dados.
Se seu conjunto de dados incluir um atributo de geolocalização, defina o atributo no esquema com o tipo de atributo `geolocation`. Para obter mais informações, consulte [Como adicionar informações de geolocalização](weather.md#adding-geolocation). Para aplicar o [Weather Index](weather.md), você deve incluir um atributo de geolocalização na série temporal de destino e em qualquer conjunto de dados de séries temporais relacionadas.
Alguns domínios têm dimensões opcionais que recomendamos incluir. As dimensões opcionais são listadas nas descrições de cada domínio posteriormente neste guia. Para ver um exemplo, consulte [Domínio RETAIL](retail-domain.md). Todas as dimensões opcionais têm o tipo de dados `string`.
Para cada conjunto de dados, é necessário um esquema. Veja a seguir o esquema que acompanha o exemplo de conjunto de dados de séries temporais de destino acima.
```
{
"attributes": [
{
"AttributeName": "timestamp",
"AttributeType": "timestamp"
},
{
"AttributeName": "item_id",
"AttributeType": "string"
},
{
"AttributeName": "store",
"AttributeType": "string"
},
{
"AttributeName": "demand",
"AttributeType": "float"
}
]
}
```
Ao fazer upload dos dados de treinamento para o conjunto de dados que usa esse esquema, o Forecast pressupõe que o campo `timestamp` é a coluna 1, o campo `item_id` é a coluna 2, o campo `store` é a coluna 3 e o campo `demand`, o campo de *destino*, é a coluna 4.
Para o tipo de conjunto de dados de séries temporais relacionadas, todos os recursos relacionados devem ter um tipo de atributo flutuante ou inteiro. Para o tipo de conjunto de dados de metadados de itens, todos os recursos devem ter um tipo de atributo de string. Para obter mais informações, consulte [SchemaAttribute](API_SchemaAttribute.md).
**nota**
Um par `attributeName` e `attributeType` é necessário para cada coluna no conjunto de dados. O Forecast reserva vários nomes que não podem ser usados como nome de um atributo de esquema. Para obter a lista de nomes reservados, consulte [Nomes de campo reservados](reserved-field-names.md).
## Grupos de conjuntos de dados
Um *grupo de conjuntos de dados* é uma coleção de um a três conjuntos de dados complementares, um de cada tipo de conjunto de dados. Importa conjuntos de dados para um grupo de conjuntos de dados e use o grupo de conjuntos de dados para treinar um preditor.
O Forecast inclui as seguintes operações para criar grupos de conjuntos de dados e adicionar conjuntos de dados a eles:
+ [CreateDatasetGroup](API_CreateDatasetGroup.md)
+ [UpdateDatasetGroup](API_UpdateDatasetGroup.md)
## Resolver conflitos na frequência da coleta de dados
O Forecast pode treinar preditores com dados que não se alinham à frequência de dados especificada na operação [CreateDataset](API_CreateDataset.md). Por exemplo, você pode importar dados registrados em intervalos de hora em hora, mesmo que alguns dos dados não tenham carimbo de data e hora no início da hora (02:20, 02:45). O Forecast usa a frequência de dados especificada para aprender sobre seus dados. Em seguida, o Forecast agrega os dados durante o treinamento do preditor. Para obter mais informações, consulte [Agregação de dados para diferentes frequências de previsão](data-aggregation.md).