As traduções são geradas por tradução automática. Em caso de conflito entre o conteúdo da tradução e da versão original em inglês, a versão em inglês prevalecerá.
Gerenciamento do cache de clusters
O armazenamento em cache é um dos recursos mais importantes de qualquer banco de dados (DB) porque ajuda a reduzir o disco I/O. Os dados acessados com mais frequência são armazenados em uma área de memória chamada cache de buffer. Quando uma consulta é executada com frequência, ela recupera os dados diretamente do cache em vez do disco. Esse processo é mais rápido e oferece melhor escalabilidade e performance da aplicação. Configure o tamanho do cache do PostgreSQL usando o parâmetro shared_buffers. Para obter mais informações, consulte Memória
Após um failover, o gerenciamento de cache de cluster (CCM) na Amazon PostgreSQL-Compatible Aurora Edition foi projetado para melhorar o desempenho de recuperação de aplicativos e bancos de dados. Em uma situação de failover sem o CCM, talvez você perceba uma degradação de performance temporária, mas significativa, depois do failover. Isso ocorre porque, quando a instância do banco de dados de failover é iniciada, o cache do buffer está vazio. Um cache vazio também é conhecido como um cache frio. A instância do banco de dados deve ler do disco, o que é mais lento do que a leitura do cache.
Ao implementar o CCM, você escolhe uma instância de banco de dados de leitura preferencial e o CCM sincroniza continuamente sua memória cache com a da instância de banco de dados principal, ou de gravação. Em caso de failover, a instância de banco de dados preferencial é promovida para a nova instância de banco de dados de gravação. Como ela já tem uma memória cache, conhecida como cache quente, isso minimiza o impacto do failover na performance da aplicação?
Como funciona o gerenciamento do cache de clusters?
As instâncias de banco de dados de failover estão localizadas em zonas de disponibilidade diferentes da instância de banco de dados principal, de gravação. A instância de banco de dados de leitura preferencial é o destino prioritário de failover, o qual é especificada atribuindo-se a ela o nível de prioridade nível 0.
nota
A prioridade da camada de promoção é um valor que especifica a ordem em que um leitor do Aurora é promovido para a instância de banco de dados do leitor depois de uma falha. Os valores válidos são 0 – 15, em que 0 é a primeira prioridade, e 15 é a última prioridade. Para obter mais informações sobre o nível de promoçao, consulte Tolerância a falhas para um cluster de bancos de dados Aurora. Modificar o nível de promoção não causa interrupções.
O CCM sincroniza o cache da instância de banco de dados de gravação com a instância de banco de dados de leitura preferencial. A instância de banco de dados de leitura envia o conjunto de endereços de buffer armazenados em cache para a instância de banco de dados de gravação na forma de um filtro de bloom. Um filtro de bloom é uma estrutura de dados probabilística e eficiente em termos de memória usada para testar se um elemento é membro de um conjunto. O uso de um filtro de bloom impede que a instância de banco de dados de leitura envie os mesmos endereços de buffer para a instância de banco de dados de gravação repetidamente. Quando a instância de banco de dados de gravação recebe o filtro de bloom, ela compara os blocos em seu cache de buffer e envia os buffers usados com frequência para a instância de banco de dados de leitura. Por padrão, um buffer é considerado usado com frequência quando sua contagem de uso é superior a três.
O diagrama a seguir mostra como o CCM sincroniza o cache de buffer da instância de banco de dados de gravação com a instância de banco de dados de leitura preferencial.
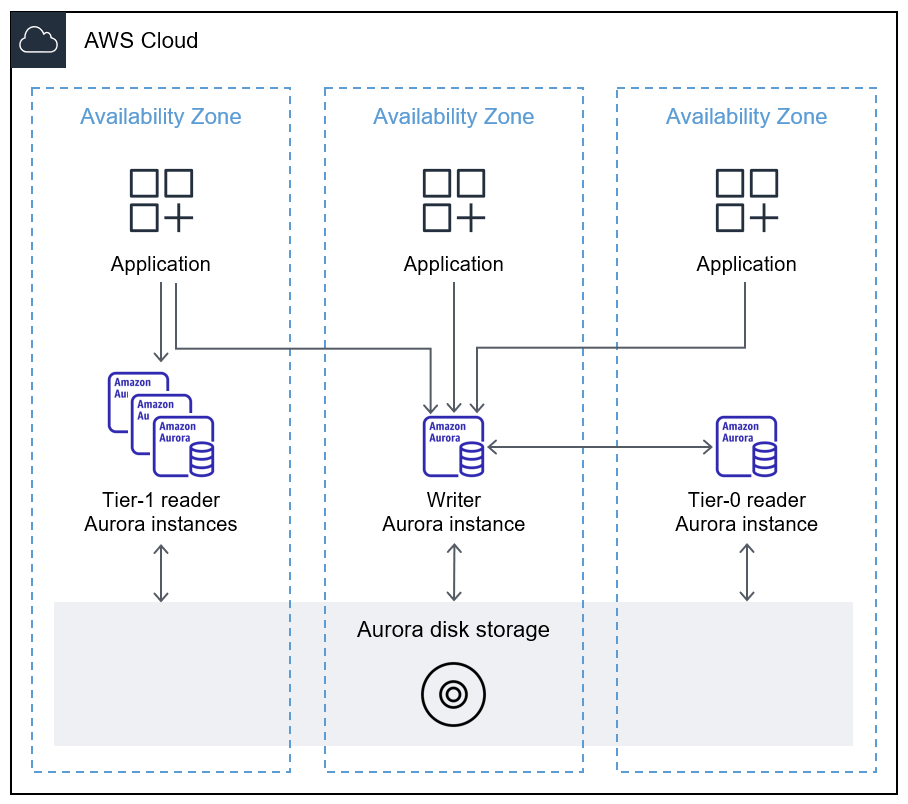
Para obter mais informações sobre o CCM, consulte Recuperação rápida após failover com gerenciamento de cache de cluster para o Aurora PostgreSQL (documentação do Aurora) e Introdução ao gerenciamento de cache de cluster do Aurora
Limitações
O recurso CCM apresenta as seguintes limitações:
-
A instância de banco de dados de leitura deve ter o mesmo tipo e tamanho de classe da instância de banco de dados do Amazon, como
r5.2xlargeoudb.r5.xlarge. -
Não há suporte ao CCM para clusters de banco de dados Aurora PostgreSQL que fazem parte de bancos de dados globais do Aurora.
Casos de uso do gerenciamento do cache de clusters
Para alguns setores, como varejo, bancos e finanças, atrasos de apenas alguns milissegundos podem causar problemas de performance de aplicações e resultar em perdas significativas de negócios. Como o CCM ajuda a recuperar a performance de aplicações e bancos de dados sincronizando continuamente o cache de buffer da instância principal do banco de dados com a instância de backup preferencial, ele pode ajudar a evitar perdas comerciais associadas a failovers.
