本文属于机器翻译版本。若本译文内容与英语原文存在差异,则一律以英文原文为准。
# 成本优化-网络
为高可用性 (HA) 设计系统是实现弹性和容错能力的最佳实践。实际上,这意味着将您的工作负载和底层基础设施分散到给定 AWS 区域的多个可用区 (AZ)。确保您的 Amazon EKS 环境具备这些特性将增强系统的整体可靠性。与此同时,您的 EKS 环境可能还将由各种结构(即 VPC)、组件(即 ELB)和集成(即 ECR 和其他容器注册表)组成。
高可用系统和其他特定用例组件的组合可以在数据的传输和处理中发挥重要作用。这反过来将影响因数据传输和处理而产生的成本。
下文详述的做法将帮助您设计和优化 EKS 环境,以实现不同领域和用例的成本效益。
## Pod 到 Pod 通信
根据您的设置,Pod 之间的网络通信和数据传输可能会对运行 Amazon EKS 工作负载的总体成本产生重大影响。本节将介绍降低与 Pod 间通信相关的成本的不同概念和方法,同时考虑高可用性 (HA) 架构、应用程序性能和弹性。
### 将流量限制到可用区
Kubernetes项目很早就开始开发拓扑感知结构,包括像kubernetes这样的标签。io/hostname,topology.kubernetes。io/region,以及 topology.kubernetes。io/zone 分配给节点以启用诸如跨故障域分配工作负载和拓扑感知卷配置器之类的功能。在 Kubernetes 1.17 版本中升级后,这些标签还被用来为 Pod 到 Pod 的通信启用拓扑感知路由功能。
以下是一些有关如何控制 EKS 集群中 Pod 之间的跨可用区流量以降低成本和最大限度地减少延迟的策略。
*如果你想详细了解集群中 Pod 之间的跨可用区流量(例如以字节为单位传输的数据量),[请参阅这篇文章。](https://aws.amazon.com/blogs/containers/getting-visibility-into-your-amazon-eks-cross-az-pod-to-pod-network-bytes/)*

如上图所示,服务是稳定的网络抽象层,用于接收发往 Pod 的流量。创建服务时,会创建多 EndpointSlices 个。每个 EndpointSlice 都有端点列表,其中包含 Pod 地址子集以及它们运行的节点和任何其他拓扑信息。使用亚马逊 VPC CNI 时,kube-proxy 作为守护程序集在每个节点上运行。它维护网络规则以启用 Pod 通信和服务发现。替代方案 e BPF-based CNI 可能不使用 kube-proxy 但会提供等效的行为。它履行内部路由的作用,但它是根据从创建者那里消耗的资源来完成的。 EndpointSlices
在亚马逊 EKS 上,kube-proxy 主要使用 iptables NAT 规则(或 [ nftables ](https://docs.aws.amazon.com/eks/latest/best-practices/nftables.html)、[ IPVS ](https://kubernetes.io/docs/reference/networking/virtual-ips/#proxy-mode-ipvs) 作为替代方案)在集群中的所有 Pod 之间分配流量,无论其节点或可用区位于何处。这种默认分配可能导致跨可用区流量路由,从而可能导致敏感应用程序延迟增加,并在大型部署中产生跨可用区数据传输费用。
**使用拓扑感知路由(以前称为拓扑感知提示)**
当*[在 Kubernetes 服务上启用和实现](https://kubernetes.io/docs/concepts/services-networking/topology-aware-routing/)*拓扑感知路由时, EndpointSlice 控制器将按比例将终端节点分配到集群分布的不同区域。对于每个端点, EndpointSlice 控制器还将*为该区域设置*提示。*提示*描述终端节点应为哪个区域提供流量。`kube-proxy`然后,将根据应用*的提示*将流量从区域路由到终端节点。
下图显示了提示是如何 EndpointSlices 组织的,这样`kube-proxy`可以根据其区域起点知道他们应该去哪个目的地。如果没有提示,就没有这样的分配或组织,无论流量来自哪里,都将代理到不同的区域目的地。

在某些情况下, EndpointSlice 控制器可能会*对不同的区域应用*提示,这意味着终端节点最终可能会为来自不同区域的流量提供服务。这样做的原因是尝试在不同区域的端点之间保持流量的均匀分布。
以下是有关如何为服务启用*拓扑感知路由*的代码片段。
```
apiVersion: v1
kind: Service
metadata:
name: orders-service
namespace: ecommerce
annotations:
service.kubernetes.io/topology-mode: Auto
spec:
selector:
app: orders
type: ClusterIP
ports:
* protocol: TCP
port: 3003
targetPort: 3003
```
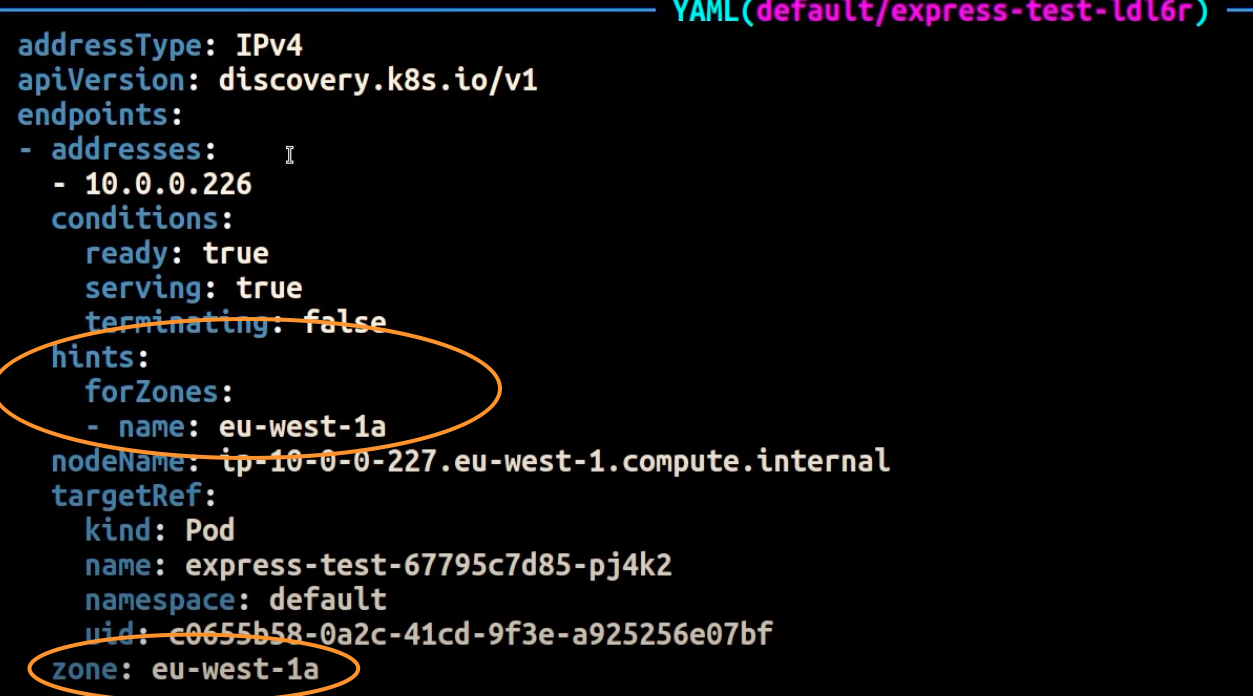
下面的屏幕截图显示了 EndpointSlice 控制器成功向运行在 AZ 中的 Pod 副本的终端节点应用提示的结果`eu-west-1a`。
**注意**
请务必注意,拓扑感知路由仍处于测试阶段。在集群拓扑中均匀分布的工作负载的情况下,此功能的性能更具可预测性,因为控制器在各个区域之间按比例分配端点,但是当区域中的节点资源过于不平衡而无法避免过度过载时,可能会跳过提示分配。因此,强烈建议将其与调度约束结合使用,以提高应用程序的可用性,例如 [ pod 拓扑分布限制](https://kubernetes.io/docs/concepts/scheduling-eviction/topology-spread-constraints/)。请注意,当容量在各个区域之间波动时,例如使用 [ Amazon EC2 竞价型实例时,也可能不会分配提示](https://aws.amazon.com/ec2/spot/),因为在计算比例分配时不会实时检测到中断或替换。
**使用流量分配 **
[流量分配在 Kubernetes 1.30 中引入并在 1.33 中正式发布,它为同区域流量偏好](https://kubernetes.io/docs/reference/networking/virtual-ips/#traffic-distribution)提供了拓扑感知路由的更简单替代方案。尽管拓扑感知路由尝试使用智能方法进行流量路由以避免端点过载,但它导致了不可预测的行为。相反,流量分配优先考虑可预测性。该 PreferClose 选项指示 kube-proxy 创建规则,根据控制器*设置的区域*提示首先将流量路由到同区域终端节点。 EndpointSlice 如果没有相同区域的终端节点可用,则只能在服务的任何集群终端节点上分配流量。此功能专为那些接受权衡的负载而非拓扑感知路由提供的负载均匀分布,而非尝试均匀分配负载的工作负载。
以下是有关如何为服务启用*流量分配*的代码片段。
```
apiVersion: v1
kind: Service
metadata:
name: orders-service
namespace: ecommerce
spec:
trafficDistribution: PreferClose
selector:
app: orders
type: ClusterIP
ports:
* protocol: TCP
port: 3003
targetPort: 3003
```
启用流量分配时,会出现一个常见的挑战:如果大多数流量来自同一区域,则单个可用区内的端点可能会过载。这种过载可能会造成重大问题:
+ 管理多可用区部署的单个水平容器自动扩缩器 (HPA) 可以通过在不同的可用区横向扩展 pod 来做出响应。但是,此操作无法有效解决受影响区域中增加的负载问题。
+ 这种情况反过来可能导致资源效率低下。当集群自动扩缩器(如 Karpenter)检测到容器在不同可用区横向扩展时,他们可能会在未受影响的可用区中预置更多节点,从而导致不必要的资源分配。
为了克服这一挑战:
+ 为每个区域创建单独的部署,这些部署将有自己的 HPA,可以相互独立扩展。
+ 利用拓扑分布约束来确保集群中的工作负载分布,这有助于防止高流量区域的端点过载。
**使用 Autoscaler:将节点配置到特定 AZ **
*我们强烈建议您在多个可用区的高可用环境中*运行工作负载。这提高了应用程序的可靠性,尤其是在出现可用区问题事件时。如果您愿意为了降低网络相关成本而牺牲可靠性,则可以将节点限制在单个可用区内。
要在同一 AZ 中运行所有 Pod,要么在同一 AZ 中配置工作节点,要么在同一 AZ 上运行的工作节点上调度 Pod。要在单个可用区内配置节点,请使用[集群自动扩缩器 (CA) 定义一个节点组,其子网属于同一可用区。](https://github.com/kubernetes/autoscaler/tree/master/cluster-autoscaler)对于 [ Karpenter,](https://karpenter.sh/)使用`topology.kubernetes.io/zone`并指定要在其中创建工作节点的可用区。例如,以下 Karpenter 配置器代码段在 us-west-2a AZ 中预置节点。
**Karpenter**
```
apiVersion: karpenter.sh/v1
kind: Provisioner
metadata:
name: single-az
spec:
requirements:
* key: "topology.kubernetes.io/zone"`
operator: In
values: ["us-west-2a"]
```
**集群自动扩缩器 (CA) **
```
apiVersion: eksctl.io/v1alpha5
kind: ClusterConfig
metadata:
name: my-ca-cluster
region: us-east-1
version: "1.21"
availabilityZones:
* us-east-1a
managedNodeGroups:
* name: managed-nodes
labels:
role: managed-nodes
instanceType: t3.medium
minSize: 1
maxSize: 10
desiredCapacity: 1
...
```
**使用 Pod 分配和节点亲和性 **
或者,如果您的工作节点在多个可用区中运行,则每个节点的标签都将为 * [ topology.kubernetes。io/zone](http://topology.kubernetes.io/zone%E2%80%9D)*使用其 AZ 的值(例如 us-west-2a 或 us-west-2b)。你可以使用`nodeSelector`或将 Pod 调度`nodeAffinity`到单个 AZ 中的节点。例如,以下清单文件将在 AZ us-west-2a 中运行的节点内调度 Pod。
```
apiVersion: v1
kind: Pod
metadata:
name: nginx
labels:
env: test
spec:
nodeSelector:
topology.kubernetes.io/zone: us-west-2a
containers:
* name: nginx
image: nginx
imagePullPolicy: IfNotPresent
```
### 限制节点的流量
在某些情况下,仅在区域级别限制流量是不够的。除了降低成本外,您可能还需要减少某些经常相互通信的应用程序之间的网络延迟。为了实现最佳网络性能并降低成本,您需要一种将流量限制到特定节点的方法。例如,即使在高可用性 (HA) 设置中,微服务 A 也应始终与节点 1 上的微服务 B 通信。让节点 1 上的微服务 A 与节点 2 上的微服务 B 通信,可能会对这种性质的应用程序的预期性能产生负面影响,尤其是当节点 2 完全位于一个单独的可用区时。
**使用服务内部流量策略 **
为了限制节点的 Pod 网络流量,你可以使用*[服务内部流量策略](https://kubernetes.io/docs/concepts/services-networking/service-traffic-policy/)*。默认情况下,发送到工作负载服务的流量将随机分布在生成的不同端点上。因此,在 HA 架构中,这意味着来自微服务 A 的流量可以流向不同可用区中任何给定节点上的微服务 B 的任何副本。但是,将服务的内部流量策略设置为`Local`,流量将仅限于流量来源节点上的端点。该政策规定只能使用节点本地端点。意味着,该工作负载的网络流量相关成本将低于全集群分布时的网络流量相关成本。此外,延迟将降低,从而提高应用程序的性能。
**注意**
请务必注意,此功能不能与 Kubernetes 中的拓扑感知路由结合使用。

以下是有关如何为服务设置*内部流量策略*的代码片段。
```
apiVersion: v1
kind: Service
metadata:
name: orders-service
namespace: ecommerce
spec:
selector:
app: orders
type: ClusterIP
ports:
* protocol: TCP
port: 3003
targetPort: 3003
internalTrafficPolicy: Local
```
为避免由于流量下降而导致应用程序出现意外行为,应考虑以下方法:
+ 为每个通信 Pod 运行足够的副本
+ 使用[拓扑分布约束使 Pod 分布相对均匀 ](https://kubernetes.io/docs/concepts/scheduling-eviction/topology-spread-constraints/)
+ 使用 [ pod 关联性规则将通信 Pod 放在同](https://kubernetes.io/docs/concepts/scheduling-eviction/assign-pod-node/#inter-pod-affinity-and-anti-affinity)一个地方
在此示例中,您有 2 个微服务 A 副本和 3 个微服务 B 副本。如果微服务 A 的副本分布在节点 1 和 2 之间,而微服务 B 的所有 3 个副本都位于节点 3 上,则由于内部流量策略,它们将无法通信。`Local`当没有可用的节点本地端点时,流量会丢失。

如果微服务 B 在节点 1 和 2 上确实有 3 个副本中的 2 个,则对等应用程序之间将进行通信。但是你仍然会有微服务 B 的独立副本,没有任何对等副本可供通信。

**注意**
在某些情况下,如上图所示的隔离副本如果仍能起到一定作用(例如为来自外部传入流量的请求提供服务),则可能不会令人担忧。
**使用具有拓扑分布约束的服务内部流量策略 **
将*内部流量策略*与*拓扑分布限制*结合使用有助于确保有正确数量的副本用于在不同节点上通信微服务。
```
apiVersion: apps/v1
kind: Deployment
metadata:
name: express-test
spec:
replicas: 6
selector:
matchLabels:
app: express-test
template:
metadata:
labels:
app: express-test
tier: backend
spec:
topologySpreadConstraints:
- maxSkew: 1
topologyKey: "topology.kubernetes.io/zone"
whenUnsatisfiable: ScheduleAnyway
labelSelector:
matchLabels:
app: express-test
```
**将服务内部流量策略与 Pod 关联性规则结合使用 **
另一种方法是在使用服务内部流量策略时使用 Pod 关联性规则。利用 Pod 关联性,你可以影响调度器将某些 Pod 放在同一个地方,因为它们经常通信。通过对特定 Pod 应用严格的调度约束 (`requiredDuringSchedulingIgnoredDuringExecution`),当调度器将 Pod 放置在节点上时,这将为你提供 Pod 共置的更好结果。
```
apiVersion: apps/v1
kind: Deployment
metadata:
name: graphql
namespace: ecommerce
labels:
app.kubernetes.io/version: "0.1.6"
...
spec:
serviceAccountName: graphql-service-account
affinity:
podAffinity:
requiredDuringSchedulingIgnoredDuringExecution:
- labelSelector:
matchExpressions:
- key: app
operator: In
values:
- orders
topologyKey: "kubernetes.io/hostname"
```
## 负载平衡器与 Pod 的通信
EKS 工作负载通常由负载均衡器前置,该负载均衡器将流量分配到 EKS 集群中的相关 Pod。您的架构可能包括内部面向 and/or 外部的负载均衡器。根据您的架构和网络流量配置,负载均衡器和 Pod 之间的通信可能会产生大量的数据传输费用。
您可以使用 [ AWS 负载均衡器控制器](https://kubernetes-sigs.github.io/aws-load-balancer-controller)自动管理 ELB 资源(ALB 和 NLB)的创建。您在此类设置中产生的数据传输费用将取决于网络流量所采用的路径。AWS 负载均衡器控制器支持两种网络流量模式,即*实例模式*和 * ip 模式*。
使用*实例模式时*, NodePort 将在您的 EKS 集群中的每个节点上打开。然后,负载均衡器将在节点之间均匀地代理流量。如果节点上运行了目标 Pod,则不会产生任何数据传输费用。但是,如果目标 Pod 位于与 NodePort 接收流量的不同节点上且处于不同的可用区,则从 kube-proxy 到目标 Pod 的网络跳数将额外增加。在这种情况下,将产生跨可用区数据传输费用。由于节点间流量分布均匀,因此从 kube-proxies 到相关目标 Pod 的跨区域网络流量跳跃很可能会产生额外的数据传输费用。
下图描绘了流量从负载均衡器流向另一个可用区的单独节点上的目标 Pod 的网络路径 NodePort,随后又从该负载均衡器流`kube-proxy`向目标 Pod。这是*实例模式*设置的示例。

使用 i * p 模式时*,网络流量从负载均衡器直接代理到目标 Pod。因此,这种方法*不*涉及数据传输费用。
**注意**
建议您将负载均衡器设置为 * ip 流量模式*以降低数据传输费用。对于此设置,还必须确保将负载均衡器部署在您的 VPC 中的所有子网上。
下图描绘了在网络 * IP 模式*下流量从负载均衡器流向 Pod 的网络路径。

## 从容器注册表传输数据
### Amazon ECR
数据传输到亚马逊 ECR 私有注册表是免费的。*In-region 数据传输不产生任何费用*,但是向互联网和跨区域传输的数据将按传输双方的互联网数据传输费率收费。
您应该利用 ECR 的内置[镜像复制功能](https://docs.aws.amazon.com/AmazonECR/latest/userguide/replication.html)将相关的容器镜像复制到与您的工作负载相同的区域。这样,复制将只收取一次费用,所有相同的区域(区域内)映像拉取都将免费。
通过*使用接[口 VPC 终端节点](https://docs.aws.amazon.com/whitepapers/latest/aws-privatelink/what-are-vpc-endpoints.html)连接到区域内 ECR 存储库,您可以进一步降低与从 ECR 提取镜像(数据传出)相关的数据传输成本。*连接到 ECR 的公有 AWS 终端节点(通过 NAT 网关和互联网网关)的替代方法将产生更高的数据处理和传输成本。下一节将更详细地介绍如何降低工作负载与 AWS 服务之间的数据传输成本。
如果您使用特别大的图像运行工作负载,则可以使用预缓存的容器映像构建自己的自定义 Amazon 系统映像 (AMI)。这可以减少初始镜像提取时间以及从容器注册表到 EKS 工作节点的潜在数据传输成本。
## 数据传输到互联网 & AWS 服务
通过互联网将 Kubernetes 工作负载与其他 AWS 服务或第三方工具和平台集成是一种常见的做法。用于将流量路由到相关目的地或从相关目的地路由流量的底层网络基础设施可能会影响数据传输过程中产生的成本。
### 使用 NAT 网关
NAT 网关是执行网络地址转换 (NAT) 的网络组件。下图描绘了 EKS 集群中的 Pod 与其他 AWS 服务(亚马逊 ECR、DynamoDB 和 S3)和第三方平台通信。在此示例中,Pod 在不同可用区的私有子网中运行。为了发送和接收来自互联网的流量,将 NAT 网关部署到一个可用区的公有子网中,允许任何具有私有 IP 地址的资源共享一个公有 IP 地址来访问互联网。该NAT网关反过来与互联网网关组件通信,允许将数据包发送到其最终目的地。

针对此类用例使用 NAT 网关时,*您可以通过在每个可用区*部署 NAT 网关来最大限度地降低数据传输成本。这样,路由到互联网的流量将通过同一可用区中的 NAT 网关,从而避免了可用区间的数据传输。但是,尽管您可以节省跨可用区数据传输的费用,但这种设置的含义是,您将在架构中额外支付 NAT 网关的费用。
这种推荐的方法如下图所示。

### 使用 VPC 终端节点
为了进一步降低此类架构的成本,*您应使用 [ VPC 终端节点](https://docs.aws.amazon.com/whitepapers/latest/aws-privatelink/what-are-vpc-endpoints.html)在工作负载和 AWS 服务之间建立连接*。VPC 终端节点允许您从 VPC 内访问 AWS 服务,而无需 data/network 数据包通过互联网。所有流量都是内部流量并停留在 AWS 网络内。有两种类型的 VPC 终端节点:接口 VPC 终端节点(由许多 AWS 服务[支持](https://docs.aws.amazon.com/vpc/latest/privatelink/aws-services-privatelink-support.html))和网关 VPC 终端节点(仅由 S3 和 DynamoDB 支持)。
**网关 VPC 端点 **
*没有与网关 VPC 终端节点相关的每小时或数据传输费用*。使用网关 VPC 终端节点时,请务必注意它们不可跨越 VPC 边界扩展。它们不能用于 VPC 对等互连、VPN 网络或通过直接连接。
**接口 VPC 端点 **
VPC 终端节点[按小时收费,](https://aws.amazon.com/privatelink/pricing/)并会收取与通过底层 ENI 进行数据处理相关的额外费用。请注意,AZ 间数据传输[不收费](https://aws.amazon.com/about-aws/whats-new/2022/04/aws-data-transfer-price-reduction-privatelink-transit-gateway-client-vpn-services/)。
下图显示了 Pod 通过 VPC 终端节点与 AWS 服务进行通信。

## VPC 之间的数据传输
在某些情况下,您的工作负载可能位于不同的 VPC(在同一 AWS 区域内),需要相互通信。这可以通过允许流量通过连接到相应 VPC 的互联网网关穿越公共互联网来实现。可以通过在公有子网中部署 EC2 实例、NAT 网关或 NAT 实例等基础设施组件来启用此类通信。但是,包含这些组件的设置将对进出 VPC processing/transferring 的数据产生费用。如果进出各个 VPC 的流量跨可用区流动,则数据传输将产生额外费用。下图描述了使用 NAT 网关和互联网网关在不同 VPC 中的工作负载之间建立通信的设置。

### VPC 对等连接
为了降低此类用例的成本,您可以使用 [ VPC 对等互连](https://docs.aws.amazon.com/vpc/latest/peering/what-is-vpc-peering.html)。使用 VPC 对等连接,对于停留在同一可用区内的网络流量,不收取任何数据传输费用。如果流量穿过可用区,则会产生费用。尽管如此,建议采用 VPC 对等互连方法,以便在同一 AWS 区域内各个 VPC 中的工作负载之间进行经济高效的通信。但是,请务必注意,VPC 对等互连主要对 1:1 的 VPC 连接有效,因为它不允许传递网络。
下图是通过 VPC 对等连接进行的工作负载通信的高级表示。

### 传递性网络连接
正如上一节所指出的,VPC 对等连接不允许传递网络连接。如果您想连接 3 个或更多具有传递网络要求的 VPC,则应使用[传输网关 ](https://docs.aws.amazon.com/vpc/latest/tgw/what-is-transit-gateway.html) (TGW)。这将使您能够克服 VPC 对等互连的限制或与在多个 VPC 之间建立多个 VPC 对等连接相关的任何运营开销。对于发送到 TGW 的数据[,您需要按小时](https://aws.amazon.com/transit-gateway/pricing/)计费。*流经 TGW 的跨可用区流量没有目的地成本。*
下图显示了不同 VPC 中但位于同一 AWS 区域内的工作负载之间通过 TGW 的可用区间流量。

## 使用服务网格
服务网格提供强大的联网功能,可用于降低 EKS 集群环境中的网络相关成本。但是,如果采用服务网格,则应仔细考虑服务网格将给您的环境带来的操作任务和复杂性。
### 限制流量到可用区
**使用 Istio 的局部加权分布 **
Istio 使您能够在*路由发生*后将网络策略应用于流量。这是使用[目的地规则(](https://istio.io/latest/docs/reference/config/networking/destination-rule/)例如[位置加权分布](https://istio.io/latest/docs/tasks/traffic-management/locality-load-balancing/distribute/))完成的。使用此功能,您可以根据其来源控制可以到达特定目的地的流量的重量(以百分比表示)。这些流量的来源可以来自外部(或面向公众的)负载均衡器,也可以来自集群本身的 Pod。当所有 Pod 端点都可用时,将根据加权循环负载平衡算法选择位置。如果某些终端节点运行状况不佳或不可用,[则将自动调整位置权重](https://www.envoyproxy.io/docs/envoy/latest/intro/arch_overview/upstream/load_balancing/locality_weight.html)以反映可用终端节点的这种变化。
**注意**
在实施位置加权分布之前,您应该首先了解您的网络流量模式以及目标规则策略可能对应用程序行为产生的影响。因此,使用 [ AWS X-Ray ](https://aws.amazon.com/xray/) 或 [ Jaeger ](https://www.jaegertracing.io/) 等工具建立分布式跟踪机制非常重要。
上面详述的 Istio 目标规则也可以应用于管理从负载均衡器到 EKS 集群中 Pod 的流量。可以将位置加权分配规则应用于从高可用性负载均衡器(特别是 Ingress Gateway)接收流量的服务。这些规则允许您根据其分区来源(本例中为负载均衡器)来控制流向何处。如果配置正确,与将流量均匀或随机分配到不同可用区中的 Pod 副本的负载均衡器相比,产生的跨区域出口流量将更少。
以下是 Istio 中目标规则资源的代码块示例。如下所示,该资源为来自该`eu-west-1`区域 3 个不同可用区的传入流量指定了加权配置。这些配置声明,来自给定可用区的大多数传入流量(在本例中为70%)应代理到其来源的同一可用区的目的地。
```
apiVersion: networking.istio.io/v1beta1
kind: DestinationRule
metadata:
name: express-test-dr
spec:
host: express-test.default.svc.cluster.local
trafficPolicy:
loadBalancer: +
localityLbSetting:
distribute:
- from: eu-west-1/eu-west-1a/ +
to:
"eu-west-1/eu-west-1a/_": 70
"eu-west-1/eu-west-1b/_": 20
"eu-west-1/eu-west-1c/_": 10
- from: eu-west-1/eu-west-1b/_ +
to:
"eu-west-1/eu-west-1a/_": 20
"eu-west-1/eu-west-1b/_": 70
"eu-west-1/eu-west-1c/_": 10
- from: eu-west-1/eu-west-1c/_ +
to:
"eu-west-1/eu-west-1a/_": 20
"eu-west-1/eu-west-1b/_": 10
"eu-west-1/eu-west-1c/*": 70**
connectionPool:
http:
http2MaxRequests: 10
maxRequestsPerConnection: 10
outlierDetection:
consecutiveGatewayErrors: 1
interval: 1m
baseEjectionTime: 30s
```
**注意**
可配送目的地的最小重量为 1%。这样做的原因是为了维护故障转移区域和区域,以防主目标中的终端节点运行状况不佳或不可用。
下图描绘了在 * eu-west-1 * 地区存在高可用性负载均衡器并应用位置加权分布的场景。此逻辑示意图的目标规则策略配置为将 60% 的流量从 * eu-west-1a 发送到同一 AZ 中的 Pod,而来自 eu-west-1a * 的 40% 的流量应流向 * eu-west-* 1b 中的 Pod。

### 限制流量到可用区域和节点
**在 Istio 中使用服务内部流量策略 **
为了降低与*外部*传入流量和 Pod 之间的*内部*流量相关的网络成本,你可以将 Istio 的目标规则和 Kubernetes 服务*内部流量策略结合起来。*将 Istio 目的地规则与服务内部流量策略相结合的方式将在很大程度上取决于三件事:
+ 微服务的作用
+ 微服务中的网络流量模式
+ 应如何在 Kubernetes 集群拓扑中部署微服务
下图显示了嵌套请求时的网络流会是什么样子,以及上述策略将如何控制流量。

1. 最终用户向**应用程序 A 发出请求,**而应用程序 A 又向 ** APP C 发出嵌套请求**。该请求首先发送到高度可用的负载均衡器,该负载均衡器在 AZ 1 和 AZ 2 中有实例,如上图所示。
1. 然后,Istio 虚拟服务将外部传入请求路由到正确的目的地。
1. 在请求路由后,Istio 目标规则根据其来源(AZ 1 或 AZ 2)来控制流向相应可用区的流量。
1. 然后,流量转到**应用程序 A 的服务**,然后代理到相应的 Pod 端点。如图所示,80% 的传入流量发送到可用区 1 中的 Pod 终端节点,20% 的传入流量发送到可用区 2。
1. ****然后,应用程序 A 向**应用程序 C 发出内部请求**。**应用程序 C ** 的服务启用了内部流量策略(`internalTrafficPolicy``: Local`)。
1. 由于**应用程序 C 有可用的**节点本地端点,从**应用程序 A**(在节点 1 上**)向应用程序 C 发出的内部请求**是成功的**。**
1. 由于**应用程序 C 没有可用的***节点本地端*点,****应用程序 A**(在节点 3 上)向应用程序 C 发出的内部请求**失败。** **如图所示,应用程序 C 在节点 3 上没有副本。**\* ** \*
以下屏幕截图取自这种方法的实时示例。第一组屏幕截图演示了向节点上的成功外部请求`graphql`以及从`graphql`向节点`ip-10-0-0-151.af-south-1.compute.internal`上托管`orders`副本发出的成功嵌套请求。


使用 Istio,您可以验证和导出您的代理已知的任何[上游集群](https://www.envoyproxy.io/docs/envoy/latest/intro/arch_overview/intro/terminology)和终端节点的统计信息。这有助于了解网络流量以及工作负载服务之间的分布份额。继续使用相同的示例,可以使用以下命令获取`graphql`代理已知的`orders`端点:
```
kubectl exec -it deploy/graphql -n ecommerce -c istio-proxy -- curl localhost:15000/clusters | grep orders
```
```
...
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_error::0**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_success::119**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_timeout::0**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**rq_total::119**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**health_flags::healthy**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**region::af-south-1**
orders-service.ecommerce.svc.cluster.local::10.0.1.33:3003::**zone::af-south-1b**
...
```
在这种情况下,`graphql`代理只知道与其共享节点的副本的`orders`终端节点。如果您从订单服务中删除该`internalTrafficPolicy: Local`设置,然后重新运行上面的命令,则结果将返回分布在不同节点上的副本的所有端点。此外,通过检查相应`rq_total`的端点,您会发现网络分布的份额相对均匀。因此,如果端点与在不同可用区中运行的上游服务相关联,则这种跨区域的网络分布将导致更高的成本。
如前一节所述,你可以利用 pod 亲和力将经常通信 Pod 放在同一个地方。
```
...
spec:
...
template:
metadata:
labels:
app: graphql
role: api
workload: ecommerce
spec:
affinity:
podAffinity:
requiredDuringSchedulingIgnoredDuringExecution:
- labelSelector:
matchExpressions:
- key: app
operator: In
values:
- orders
topologyKey: "kubernetes.io/hostname"
nodeSelector:
managedBy: karpenter
billing-team: ecommerce
...
```
当`graphql`和`orders`副本不在同一个节点 (`ip-10-0-0-151.af-south-1.compute.internal`) 上共存时,对的第一个请求会成功,如以`graphql`下 Postman 屏幕截图所示,而从`graphql`到的第二个嵌套请求因为 a 而`orders`失败。`200 response code` `503 response code`
 
## 其他资源
+ [使用 Istio 解决 EKS 的延迟和数据传输成本 ](https://aws.amazon.com/blogs/containers/addressing-latency-and-data-transfer-costs-on-eks-using-istio/)
+ [探索拓扑感知提示对亚马逊 Elastic Kubernetes 服务中网络流量的影响 ](https://aws.amazon.com/blogs/containers/exploring-the-effect-of-topology-aware-hints-on-network-traffic-in-amazon-elastic-kubernetes-service/)
+ [将您的 Amazon EKS Cross-AZ Pod 的可见性提高到 pod 的网络 ](https://aws.amazon.com/blogs/containers/getting-visibility-into-your-amazon-eks-cross-az-pod-to-pod-network-bytes/)
+ [使用 Istio 优化 AZ 流量 ](https://youtu.be/EkpdKVm9kQY)
+ [使用拓扑感知路由优化 AZ 流量 ](https://youtu.be/KFgE_lNVfz4)
+ [使用服务内部流量策略优化 Kubernetes 成本和性能 ](https://youtu.be/-uiF_zixEro)
+ [使用 Istio 和服务内部流量策略优化 Kubernetes 成本和性能 ](https://youtu.be/edSgEe7Rihc)
+ [Overview of Data Transfer Costs for Common Architectures](https://aws.amazon.com/blogs/architecture/overview-of-data-transfer-costs-for-common-architectures/)
+ [了解 AWS 容器服务的数据传输成本 ](https://aws.amazon.com/blogs/containers/understanding-data-transfer-costs-for-aws-container-services/)