View a markdown version of this page

预测可解释性 - Amazon Forecast

新客户不再可以使用亚马逊 Forecast。Amazon Forecast 的现有客户可以继续照常使用该服务。了解更多

本文属于机器翻译版本。若本译文内容与英语原文存在差异,则一律以英文原文为准。

预测可解释性

预测可解释性可帮助您更好地了解数据集中的属性会如何对特定时间序列(项目和维度组合)和时间点的预测产生影响。Forecast 使用名为影响力分数的指标来量化每个属性的相对影响,并确定它们是增加还是减少预测值。

例如,假设一个预测场景,其中目标是 sales,并且有两个相关的属性:price 和 color。Forecast 可能会发现商品的颜色对某些商品的销售影响很大,但对其他商品的影响可以忽略不计。它还可能发现,夏季促销活动对销售的影响很大,但是冬季促销活动效果不大。

要启用预测可解释性,您的预测器必须至少包含以下其中一项:相关时间序列、项目元数据或其他数据集,例如节假日和天气指数。请参阅限制和最佳实践了解更多信息。

要查看数据集中所有时间序列和时间点的汇总影响力分数,请使用预测器可解释性,而不是预测可解释性。请参阅预测器可解释性。

解释影响力分数

影响力分数衡量属性对预测值的相对影响。例如,如果“价格”属性的影响力分数是“商店位置”属性的两倍,则可以得出结论,某件商品的价格对预测值的影响是商店位置的两倍。

影响力分数还提供有关属性会增加还是减少预测值的信息。在控制台中,这由两个图表表示。带有蓝条的属性会增加预测值,而带有红条的属性会降低预测值。
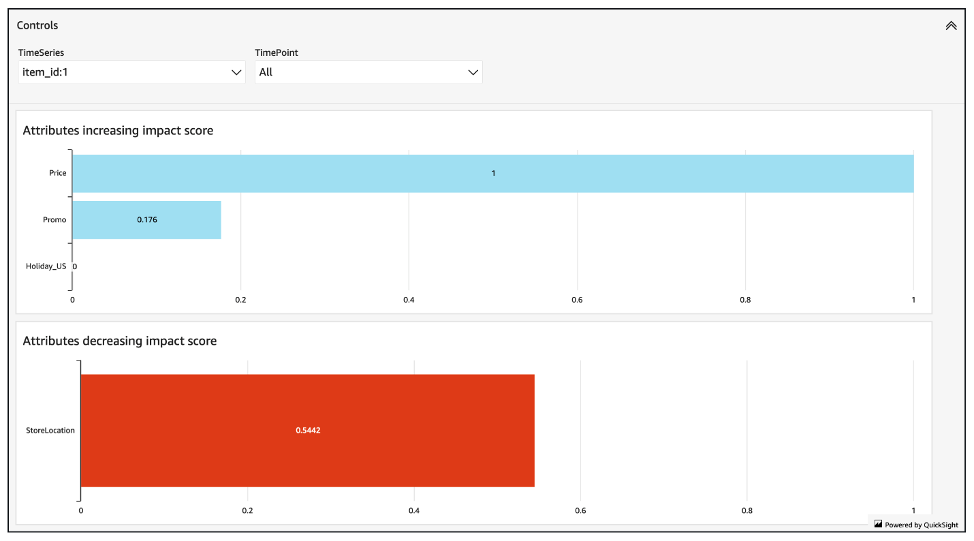
两个条形图显示 Price 和 Promo 的影响力分数增加,影响分数 StoreLocation 降低。

值得注意的是,影响力分数衡量的是属性的相对影响,而不是绝对影响。因此,不能使用影响力分数来确定特定属性是否提高了模型准确性。如果某个属性的影响力分数较低,这并不一定意味着它对预测值的影响较小;而是意味着它对预测值的影响要小于预测器使用的其他属性。

全部或部分影响力分数可能为零。如果要素对预测值没有影响,仅 AutoPredictor 使用非机器学习算法,或者您未提供相关的时间序列或项目元数据,则可能会发生这种情况。

针对预测可解释性,影响力分数有两种形式:标准化影响力分数和原始影响力分数。原始影响力分数基于 Shapley 值,没有缩放或限制。标准化影响力分数将原始分数缩放到介于 -1 和 1 之间的值。

原始影响力分数对于组合和比较不同可解释性资源的分数非常有用。例如,如果您的预测器包含 50 多个时间序列或 500 多个时间点,则可以创建多个预测可解释性资源以涵盖更多的时间序列或时间点的组合数量,并直接比较属性的原始影响力分数。但是,来自不同预测的预测可解释性资源的原始影响力分数无法直接比较。

在控制台中查看影响力分数时,只能看到标准化影响力分数。导出可解释性将为您提供原始分数和标准化分数。

创建预测可解释性

借助预测可解释性,您可以探索属性如何影响特定时间序列在特定时间点的预测值。指定时间序列和时间点后,Amazon Forecast 仅计算这些特定时间序列和时间点的影响力分数。

您可以使用软件开发工具包(SDK)或 Amazon Forecast 控制台为预测器启用预测可解释性。使用 SDK 时,请使用CreateExplainability操作。

指定时间序列

注意

时间序列是数据集中项目 (item_id) 和所有维度的组合

当您为预测可解释性指定时间序列(项目和维度组合)时,Amazon Forecast 仅计算这些特定时间序列属性的影响力分数。

要指定时间序列列表,请将通过 item_id 和维度值标识时间序列的 CSV 文件上载到 S3 存储桶中。您最多可指定 50 个时间序列。您还必须定义架构中时间序列的属性和属性类型。

例如,零售商可能想知道促销活动如何影响特定商品 (item_id) 在特定商店位置的销售 (store_location)。在此用例中,您需要指定由 item_id 和 store_location 组合的时间序列。

以下 CSV 文件选择以下五个时间序列:

  1. Item_id: 001,商店地点:西雅图

  2. Item_id: 001,商店地点:纽约

  3. Item_id: 002,商店地点:西雅图

  4. Item_id: 002,商店地点:纽约

  5. Item_id: 003,商店地点:丹佛

001, Seattle 001, New York 002, Seattle 002, New York 003, Denver

架构将第一列定义为 item_id,第二列定义为 store_location。

您可以使用 Forecast 控制台或 Forecast 软件开发工具包(SDK)指定时间序列。

Console

为预测可解释性指定时间序列

  1. 登录 AWS 管理控制台 并打开 Amazon Forecast 控制台,网址为https://console.aws.amazon.com/forecast/。

  2. 在数据集组中,选择您的数据集组。

  3. 在导航窗格中,选择 Insights。

  4. 选择创建可解释性。

  5. 在可解释性名称字段中,为预测可解释性提供一个唯一的名称。

  6. 在选择预测字段中,选择您的预测。

  7. 在S3 位置字段中,输入包含您的时间序列的文件位置。

  8. 在数据架构字段中,设置时间序列中使用的商品 ID 和维度的属性名称和属性类型。

  9. 选择创建可解释性。

SDK

为预测可解释性指定时间序列

使用该CreateExplainability操作,为其提供唯一名称 ExplainabilityName 并提供您的预测 ARN。 ResourceArn

配置以下数据类型:

  • ExplainabilityConfig-将的值设置 TimeSeriesGranularity 为 “特定” 和 TimePointGranularity “全部”。(要指定时间点,请设置 TimePointGranularity 为 “具体”。 参见指定时间点)

  • S3Config-将 “路径” 的值设置为时间序列文件的 S3 位置,将 “RoleArn” 的值设置为有权访问 S3 存储桶的角色。

  • Schema-定义 item_id 的 “AttributeNameAttributeType” 和 “” 以及时间序列中的维度。

下面的示例显示了使用“item_id”和“store_location”维度组合的时间序列架构。

{ "ExplainabilityName" : [unique_name], "ResourceArn" : [forecast_arn], "ExplainabilityConfig" { "TimeSeriesGranularity": "SPECIFIC", "TimePointGranularity": "ALL" }, "DataSource": { "S3Config": { "Path": [S3_path_to_file], "RoleArn":[role-to-access-s3-bucket] } }, "Schema": { "Attributes": [ { "AttributeName": "item_id", "AttributeType": "string" }, { "AttributeName": "store_location", "AttributeType": "string" } ] }, }

指定时间点

注意

如果您未指定时间点 ("TimePointGranularity": "ALL"),Amazon Forecast 将在计算影响力分数时考虑整个预测范围。

当您为预测可解释性指定时间点时,Amazon Forecast 会计算该特定时间范围内的属性的影响力分数。在预测范围内,您最多可以指定 500 个连续时间点。

例如,零售商可能想知道时间点的属性如何影响冬季的销售。在此用例中,零售商将指定仅跨越预测范围内冬季期间的时间点。

您可以使用 Forecast 控制台或 Forecast 软件开发工具包(SDK)指定时间点。

Console

为预测可解释性指定时间序列

  1. 登录 AWS 管理控制台 并打开 Amazon Forecast 控制台,网址为https://console.aws.amazon.com/forecast/。

  2. 在数据集组中,选择您的数据集组。

  3. 在导航窗格中,选择 Insights。

  4. 选择创建可解释性。

  5. 在可解释性名称字段中,为预测可解释性提供一个唯一的名称。

  6. 在选择预测字段中,选择您的预测。

  7. 在S3 位置字段中,输入包含您的时间序列的文件位置。

  8. 在数据架构字段中,设置时间序列中使用的商品 ID 和维度的属性名称和属性类型。

  9. 在持续时间字段中,指定日历中的开始日期和结束日期。

  10. 选择创建可解释性。

SDK

为预测可解释性指定时间序列

使用该CreateExplainability操作,为其提供唯一名称 ExplainabilityName 并提供您的预测 ARN。 ResourceArn使用以下时间戳格式设置开始日期 (StartDateTime) 和结束日期 (EndDateTime):yyyy-MM-ddTHH:mm:ss(例如:2015-01-01T20:00:00)。

配置以下数据类型:

  • ExplainabilityConfig-将的值设置 TimeSeriesGranularity 为 “特定” 和 TimePointGranularity “具体”。

  • S3Config-将 “路径” 的值设置为时间序列文件的 S3 位置,将 “RoleArn” 的值设置为有权访问 S3 存储桶的角色。

  • Schema-定义 item_id 的 “AttributeNameAttributeType” 和 “” 以及时间序列中的维度。

以下示例显示了使用“item_id”和“store_location”维度组合的时间序列架构。

{ "ExplainabilityName" : [unique_name], "ResourceArn" : [forecast_arn], "ExplainabilityConfig" { "TimeSeriesGranularity": "SPECIFIC", "TimePointGranularity": "SPECIFIC" }, "DataSource": { "S3Config": { "Path": [S3_path_to_file], "RoleArn":[role-to-access-s3-bucket] } }, "Schema": { "Attributes": [ { "AttributeName": "item_id", "AttributeType": "string" }, { "AttributeName": "store_location", "AttributeType": "string" } ] }, "StartDateTime": "string", "EndDateTime": "string", }

可视化预测可解释性

在控制台中创建预测可解释性时,Forecast 会自动可视化您的影响力分数。使用CreateExplainability操作创建 Forecast Explainability 时,EnableVisualization将其设置为 “true”,该可解释性资源的影响分数将在控制台中可视化。

影响力分数可视化自可解释性创建之日起持续 30 天。要重新创建可视化,请创建新的预测可解释性。

导出预测可解释性

注意

导出的文件可以直接从数据集导入中返回信息。如果导入的数据包含公式或命令,则文件易受 CSV 注入影响。因此,导出的文件可能会提示安全警告。为避免恶意活动,请在读取导出的文件时禁用链接和宏。

Forecast 允许您将影响力分数的 CSV 文件导出到 S3 位置。

导出内容包含指定时间序列的原始影响力分数和标准化影响力分数,以及所有指定时间序列和所有指定时间点的标准化汇总影响力分数。如果您未指定时间点,则预测范围内所有时间点的影响力分数均已汇总。
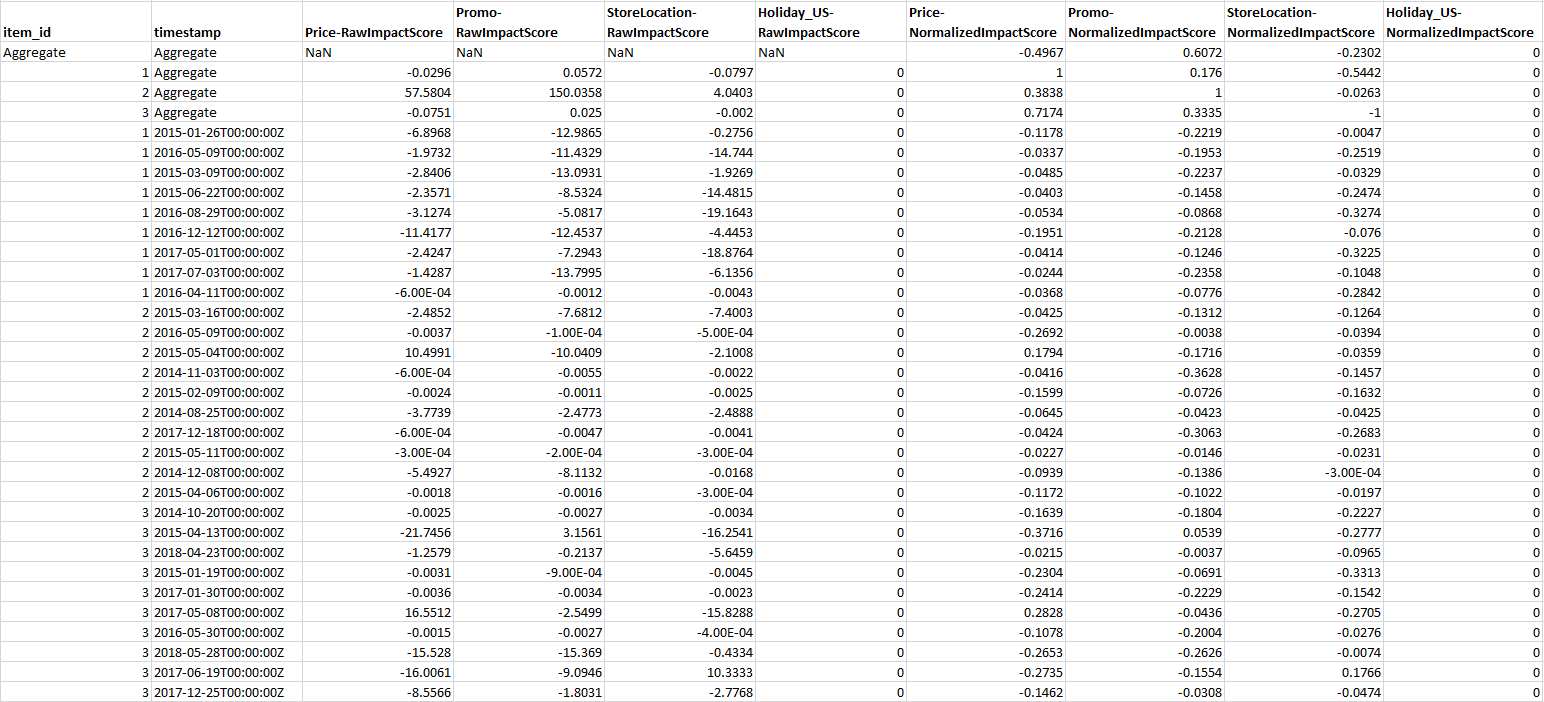
该表显示了价格、促销、商店位置和假日维度的原始影响分数和标准化影响分数。

您可以使用 Amazon Forecast 软件开发工具包(SDK)和 Amazon Forecast 控制台导出预测可解释性。

Console

导出预测可解释性

  1. 登录 AWS 管理控制台 并打开 Amazon Forecast 控制台,网址为https://console.aws.amazon.com/forecast/。

  2. 在数据集组中,选择您的数据集组。

  3. 在导航窗格中,选择 Insights。

  4. 选择您的可解释性。

  5. 从操作下拉列表中,选择导出。

  6. 在导出名称字段中,为预测可解释性导出提供一个唯一的名称。

  7. 在S3 可解释性导出位置字段中,输入用于导出 CSV 文件的 S3 位置。

  8. 在IAM 角色字段中,选择有权访问所选 S3 位置的角色。

  9. 选择创建可解释性导出。

SDK

导出预测可解释性

使用 CreateExplainabilityExport 操作,在 Destination 对象中指定您的 S3 位置和 IAM 角色,以及 ExplainabilityArn 和 ExplainabilityExportName。

例如:

{ "Destination": { "S3Config": { "Path": "s3://bucket/example-path/", "RoleArn": "arn:aws:iam::000000000000:role/ExampleRole" } }, "ExplainabilityArn": "arn:aws:forecast:region:explainability/example", "ExplainabilityName": "Explainability-export-name", }

限制和最佳实践

使用预测可解释性时,请考虑以下限制和最佳实践。

  • For@@ ecast Explainability 仅适用于从中生成的某些预测 AutoPredictor - 您无法为根据传统预测变量(自动或手动选择)生成的预测启用预测可解释性。请参阅升级到 AutoPredictor。

  • F@@ orecast Explainability 并非适用于所有模型 — ARIMA(AutoRegressive 综合移动平均线)、ETS(指数平滑状态空间模型)和 NPTS(Non-Parametric 时间序列)模型不包含外部时间序列数据。因此,即使您包含了其他数据集,这些模型也不会创建可解释性报告。

  • 可解释性需要属性 - 您的预测器必须至少包含以下其中一项:相关时间序列、项目元数据、节假日或天气指数。

  • 影响力分数为零表示没有影响 - 如果一个或多个属性的影响力分数为零,则这些属性对预测值没有显著影响。如果仅 AutoPredictor 使用非 ML 算法,或者您未提供相关的时间序列或项目元数据,则分数也可以为零。

  • 最多指定 50 个时间序列 - 每个预测可解释性最多可以指定 50 个时间序列。

  • 最多指定 500 个时间点 - 每个预测可解释性最多可以指定 500 个连续时间点。

  • Forecast 还会计算一些汇总的影响力分数 - Forecast 还将提供指定时间序列和时间点的汇总影响力分数。

  • 为单个 Forecast 创建多个预测可解释性资源 - 如果您想要 50 多个时间序列或 500 多个时间点的影响力分数,则可以分批创建可解释性资源以覆盖更大的范围。

  • 比较不同的预测可解释性资源的原始影响力分数 - 可以直接比较来自同一预测的可解释性资源的原始影响力分数。

  • 预测可解释性可视化在创建后 30 天内可用 - 要在 30 天后查看可视化,请使用相同的配置创建新的预测可解释性。