本文為英文版的機器翻譯版本,如內容有任何歧義或不一致之處,概以英文版為準。
# 在截止日期雲端中排程任務
建立任務之後, AWS 截止日期 雲端會將任務排程在與佇列相關聯的一或多個機群上進行處理。根據排程組態、為機群設定的功能,以及特定步驟的主機需求來選擇處理特定任務的機群。
下列各節提供排程任務程序的詳細資訊。
## 排程組態
您可以透過在佇列上設定排程組態,來設定截止日期雲端如何排程佇列中的任務。排程組態會控制工作者在任務間的分佈方式。
您可以使用截止日期雲端主控台或呼叫 [CreateQueue](https://docs.aws.amazon.com/deadline-cloud/latest/APIReference/API_CreateQueue.html) 或 [UpdateQueue](https://docs.aws.amazon.com/deadline-cloud/latest/APIReference/API_UpdateQueue.html) APIs來設定排程組態。
有三種可用的排程組態:
+ **優先順序,first-in-first-out**(`priorityFifo`) – 排定最高優先順序、最先提交的任務 (預設)。
+ **優先順序,平衡** (`priorityBalanced`) – 以最高優先順序將工作者平均分配到各個任務。
+ **加權、平衡** (`weightedBalanced`) – 使用加權公式來判斷工作者如何在任務之間分配。
在所有排程組態中,進行中的任務會在做出新的排程決策之前執行到完成。如果您在任務執行時變更排程組態,則變更僅適用於接下來指派工作者的情況。執行中的任務不會中斷或重新指派。
### 優先順序,first-in-first-out
優先順序,first-in-first-out(`priorityFifo`) 是新佇列的預設排程組態。Deadline Cloud 會先將工作者指派給最高優先順序的任務。當多個任務具有相同的優先順序時,最舊的 (最早提交) 任務會先收到所有可用的工作者。
當您想要嚴格排序任務時,請使用優先順序 FIFO。當任務應按提交順序一次完成一個時,此組態是適當的,例如循序管道階段或批次處理,每個任務都必須在下一個任務開始之前完成。
此組態沒有其他參數。
### 優先順序,平衡
優先順序、平衡 (`priorityBalanced`) 以最高優先順序將工作者平均分配到所有任務。當最高優先順序只有一個任務時,Deadline Cloud 會將所有工作者指派給該任務。當多個任務共用最高優先順序時,工作者會平均分配到其中。如果工作者無法平均分配,則額外的工作者會分佈在最高優先順序的任務中。
當多個藝術家或使用者以相同的優先順序提交任務,且每個使用者需要立即的意見回饋時,請使用優先順序平衡。此組態可確保沒有任何單一任務會獨佔所有可用的工作者,因此在提交之後不久就會配置所有使用者的工作者。
如果任務的剩餘任務少於工作者的份額,剩餘工作者會重新分配到相同優先順序的其他任務。如果最高優先順序的所有任務都已完全配置,剩餘工作者會層疊到下一個最高優先順序層級的任務。
此組態具有下列參數:
`renderingTaskBuffer`
控制工作者黏性。只有在轉譯任務的差異超過 `renderingTaskBuffer`值時,工作者才會從目前的任務切換到相同優先順序的另一個任務。較高的值可讓工作者在目前的任務上維持更長的時間,減少內容切換。預設值為 `1`。
### 加權、平衡
加權、平衡 (`weightedBalanced`) 使用公式來計算每個任務的權重。Deadline Cloud 會先將工作者指派給最高權重的任務。如果多個任務具有相同的權重,則工作者會分配到其中。
當您需要精細控制工作者如何分散在具有不同優先順序、錯誤率和提交時間的任務時,請使用加權平衡。此組態適用於複雜的轉譯陣列環境,其中您想要調整任務優先順序、任務存留期、錯誤處理和工作者黏性之間的平衡。
每個任務的權重計算方式如下:
```
weight = (job.Priority * priorityWeight) +
(job.Errors * errorWeight) +
((currentTimeInSeconds - job.SubmissionTime) * submissionTimeWeight) +
((job.RenderingTasks - renderingTaskBuffer) * renderingTaskWeight)
```
只有在工作者目前正在處理任務時,才會套用`renderingTaskBuffer`元件。`renderingTaskWeight` 通常設定為負值,以便具有指派工作者的任務獲得較低的權重,將其他任務帶到佇列前面。通常`errorWeight`也是負數,因此具有錯誤的作業會取消優先順序。您可以使用排程覆寫來執行最低和最高優先順序任務。
此組態具有下列參數:
`priorityWeight`
套用至任務優先順序的權重。正值表示先排定優先順序較高的任務。預設值為 `100.0`。範圍: `0`到 `10000`。
`errorWeight`
套用至任務錯誤計數的權重。負值表示會先排程沒有錯誤的任務。預設值為 `-10.0`。範圍: `-10000`到 `10000`。
`submissionTimeWeight`
套用至任務提交時間的權重 (以秒為單位)。正值表示先排程先前提交的任務。預設值為 `3.0`。範圍: `0`到 `10000`。
`renderingTaskWeight`
套用至目前為任務轉譯的任務數量的權重。負值表示接下來排定工作者較少的任務。預設值為 `-100.0`。範圍: `-10000`到 `10000`。
`renderingTaskBuffer`
轉譯任務權重生效前的轉譯任務數量。正值可讓工作者處理目前的任務。預設值為 `1`。範圍: `0`到 `1000`。
`maxPriorityOverride`
選用。設為 時`alwaysScheduleFirst`,無論加權公式為何,在最高優先順序 (100) 的任務一律會排定在其他任務之前。當多個任務具有最高優先順序時,會使用標準加權公式來中斷關聯。缺少覆寫時,最高優先順序任務會使用沒有特殊處理的標準加權公式。
`minPriorityOverride`
選用。設為 時`alwaysScheduleLast`,無論加權公式為何,一律會在其他任務之後排定最低優先順序 (0) 的任務。當多個任務具有最低優先順序時,會使用標準加權公式中斷關聯。缺少覆寫時,最低優先順序任務會使用沒有特殊處理的標準加權公式。
## 判斷機群相容性
佇列和機群會分割路由任務的工作。佇列會組織任務,並控制誰可以提交和檢視任務。機群和主機需求會選取每個步驟執行的工作者。
若要將特定工作者專用於特定任務,請為這些工作者建立單獨的機群,而不是單獨的佇列。例如,對具有特定硬體的機器或為敏感內容預留的機器使用單獨的機群。一個佇列可以與多個機群相關聯,每個步驟的主機需求都會選取相容的機群。如果您來自截止日期 10,機群和主機需求會取代工作者群組。如需完整的概念映射,請參閱 [從截止日期 10 遷移至 AWS 截止日期雲端](migrate-from-deadline-10.md)。
建立任務之後,截止日期雲端會根據與提交任務的佇列相關聯的機群功能,檢查任務中每個步驟的主機需求。如果機群符合主機需求,任務會進入 `READY` 狀態。
如果任務中的任何步驟具有與佇列相關聯的機群無法滿足的需求,則該步驟的狀態會設為 `NOT_COMPATIBLE`。此外,任務中的其餘步驟也會取消。如果您稍後將相容的機群與佇列建立關聯,現有的`NOT_COMPATIBLE`任務不會自動重新啟動 – 若要執行它們,請重新排入佇列。如需詳細資訊,請參閱[在截止日期雲端中修改任務](build-jobs-modifying.md)。
機群的功能是在機群層級設定。即使機群中的工作者符合任務的需求,如果其機群不符合任務的需求,則不會從任務指派任務。
**重要**
機群層級`workerCapabilities`宣告是排程合約。排程器只會針對機群層級功能評估步驟相容性,不會檢查個別工作者。如果步驟的 `hostRequirements`超過機群 中宣告的最小值`workerCapabilities`,則機群會評估為不相容,即使機群中的某些個別工作者符合需求。
下列任務範本有一個步驟,指定步驟的主機需求:
```
name: Sample Job With Host Requirements
specificationVersion: jobtemplate-2023-09
steps:
- name: Step 1
script:
actions:
onRun:
args:
- '1'
command: /usr/bin/sleep
hostRequirements:
amounts:
# Capabilities starting with "amount." are amount capabilities. If they start with "amount.worker.",
# they are defined by the OpenJD specification. Other names are free for custom usage.
- name: amount.worker.vcpu
min: 4
max: 8
attributes:
- name: attr.worker.os.family
anyOf:
- linux
```
提交者透過**主機需求索引標籤設定相同的需求**。選擇在**符合下列條件的工作者主機上執行**,以設定作業系統、CPU 架構和硬體範圍,而無需編輯範本。
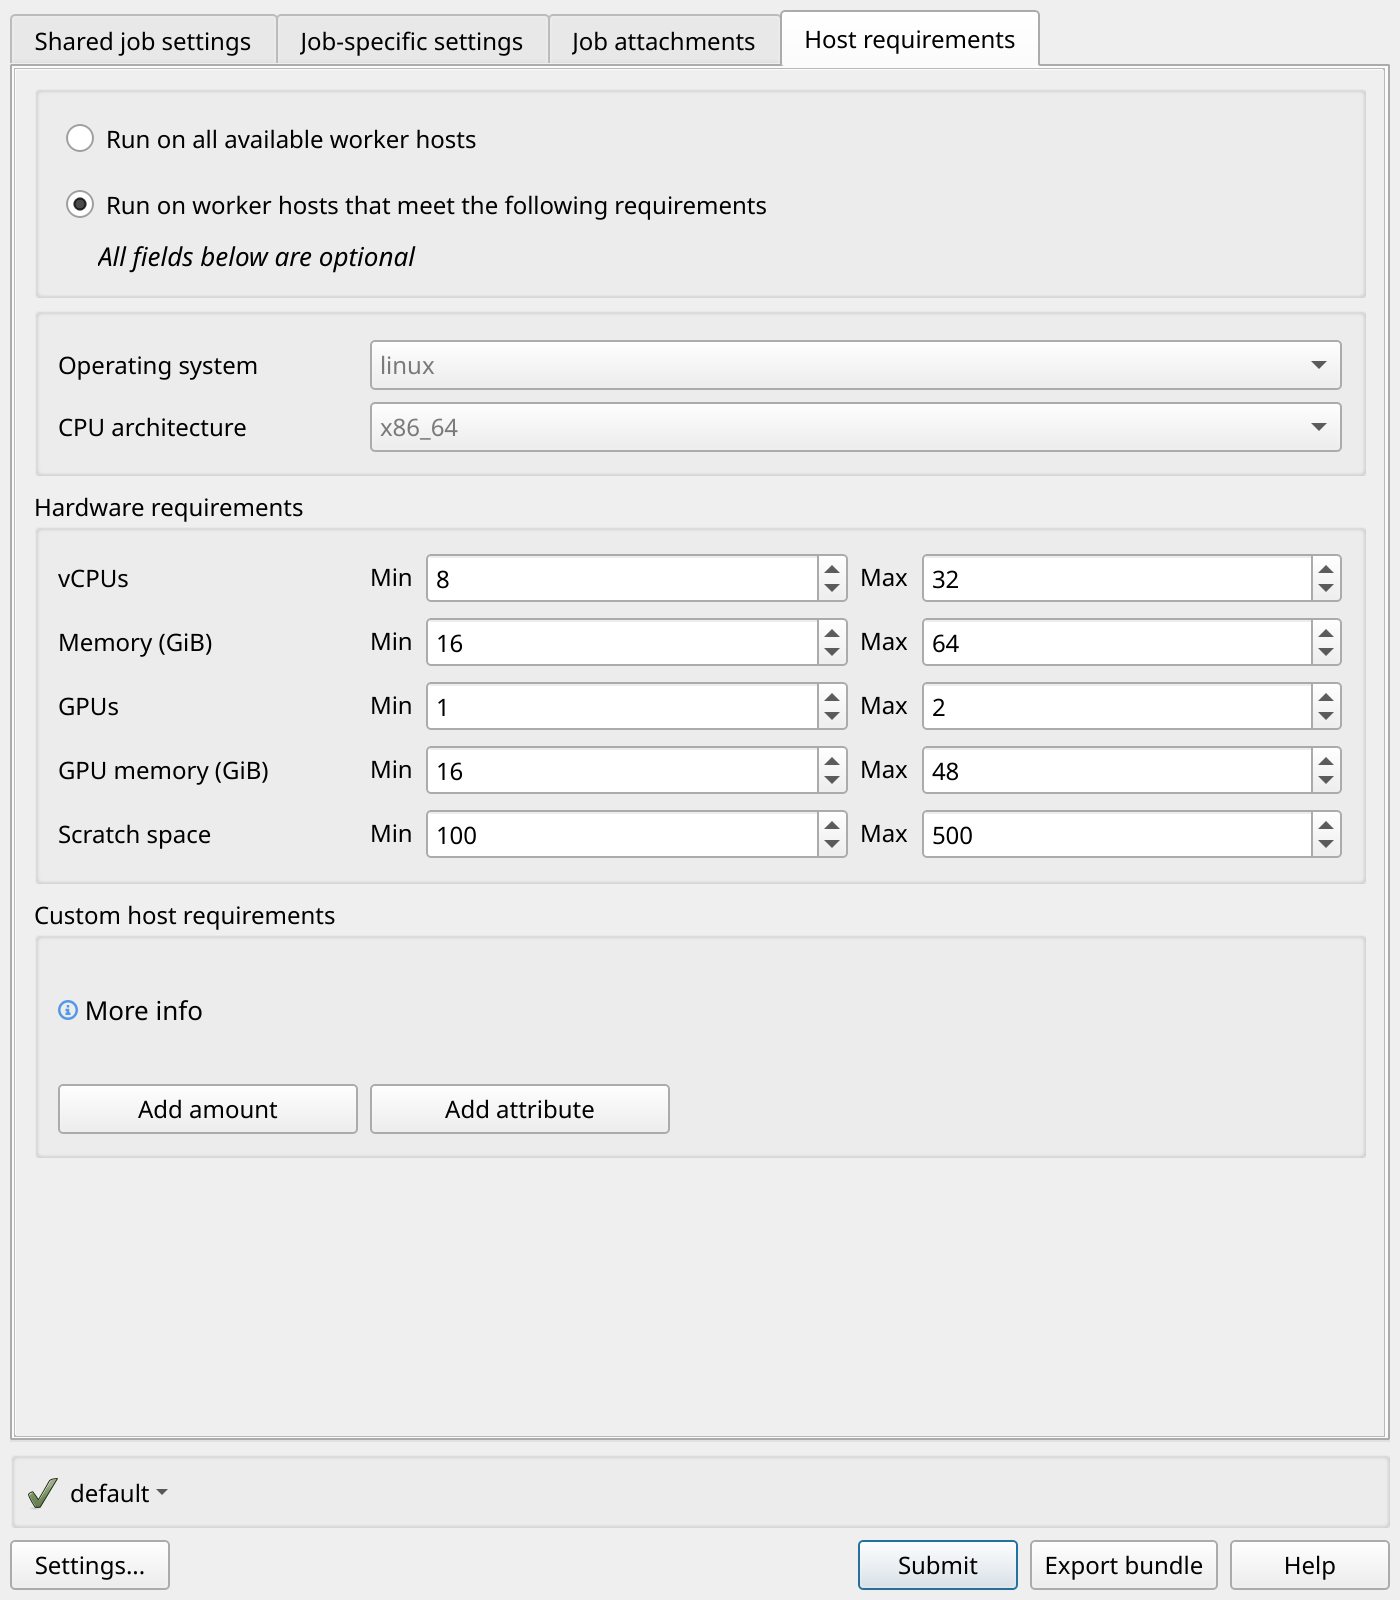
此任務可以排程到具有下列功能的機群:
```
{
"vCpuCount": {"min": 4, "max": 8},
"memoryMiB": {"min": 1024},
"osFamily": "linux",
"cpuArchitectureType": "x86_64"
}
```
此任務無法排程到具有下列任何功能的機群:
```
{
"vCpuCount": {"min": 4},
"memoryMiB": {"min": 1024},
"osFamily": "linux",
"cpuArchitectureType": "x86_64"
}
The vCpuCount has no maximum, so it exceeds the maximum vCPU host requirement.
{
"vCpuCount": {"max": 8},
"memoryMiB": {"min": 1024},
"osFamily": "linux",
"cpuArchitectureType": "x86_64"
}
The vCpuCount has no minimum, so it doesn't satisfy the minimum vCPU host requirement.
{
"vCpuCount": {"min": 4, "max": 8},
"memoryMiB": {"min": 1024},
"osFamily": "windows",
"cpuArchitectureType": "x86_64"
}
The osFamily doesn't match.
```
### 機群設計最佳實務
由於排程器會在機群層級評估相容性,因此請設計客戶受管機群,讓宣告的 `workerCapabilities`代表機群中每個工作者的保證最低硬體特性:
+ 根據保證的最低硬體特性 (例如 GPU 計數、VRAM 或 CPU 計數) 將工作者分割成多個機群,而不是使用一個具有廣泛範圍的異質機群。
+ 確保機群中的每個工作者符合或超過宣告的最小值,即使工作者沒有相同的硬體。
+ 將多個機群與單一佇列建立關聯,以便排程器根據每個步驟的 選取相容的機群`hostRequirements`。
例如,如果您的工作者具有 1 個 GPU (24 GiB VRAM),而工作者具有 4 個 GPUs (96 GiB VRAM),請建立兩個不同的機群:一個宣告至少 1 個 GPU 和 24 GiB GPU 記憶體,另一個宣告至少 4 個 GPUs 和 96 GiB GPU 記憶體。然後將兩個機群與相同的佇列建立關聯。需要 4 GPUs 的步驟會自動路由到高 GPU 機群。
如需建立客戶受管機群的詳細資訊,請參閱 [建立客戶受管機群](create-a-cmf.md)。
### 記憶體需求和執行個體大小調整
步驟的`amount.worker.memory`主機需求會選取機群。它不會調整執行個體的大小。排程器符合每個機群宣告功能的需求,而非個別工作者的需求。因此,需求不會導致服務受管機群啟動更大的執行個體。若要保證執行個體大小,請改為限制機群組態。同樣適用於其他硬體需求,例如 `amount.worker.vcpu`和 `amount.worker.gpu`。如需需求和機群組態如何劃分此工作的詳細資訊,請參閱 [主機需求和機群功能](host-requirements-overview.md)。
### 自訂功能
除了內建的工作者功能 (vCPU、記憶體、GPU、作業系統和 CPU 架構),您可以在機群上定義自訂數量和自訂屬性,以表達其他排程限制:
+ **自訂量** – 數值,例如可用磁碟空間或專用硬體計數器。
+ **自訂屬性** – 字串值,例如已安裝的軟體、求解器版本或網站標籤。例如,您可以使用 等值`attr.sw.solvers`來定義 `["vray-6", "arnold-7"]`,以路由需要特定軟體的任務。
在機群層級,只有在保證軟體或硬體組合存在於該機群中的所有工作者時,才能宣告自訂功能中的軟體或硬體組合。
機群層級自訂功能有下列限制:
+ 每個機群最多 15 個自訂數量
+ 每個機群最多 15 個自訂屬性
服務`attr.worker.*`會保留格式為 `amount.worker.*`和 的名稱,以供內建功能使用。為您的自訂功能使用其他字首。
下列範例會將需要特定求解器的步驟路由至提供求解器的機群。機群會在自訂屬性中宣告安裝在其所有工作者上的求解器。此機群組態是[CreateFleet](https://docs.aws.amazon.com/deadline-cloud/latest/APIReference/API_CreateFleet.html)請求的一部分:
```
"workerCapabilities": {
"vCpuCount": {"min": 4},
"memoryMiB": {"min": 16384},
"osFamily": "linux",
"cpuArchitectureType": "x86_64",
"customAttributes": [
{
"name": "attr.sw.solvers",
"values": ["vray-6", "arnold-7"]
}
]
}
```
需要其中一個宣告值的步驟會在任務範本中說明 `hostRequirements`中的需求:
```
steps:
- name: RenderWithVray
hostRequirements:
attributes:
- name: attr.sw.solvers
anyOf:
- vray-6
script:
actions:
onRun:
command: '{{Task.File.Render}}'
```
要求會保留未宣告 的`RenderWithVray`步進機群`vray-6`。反向不保留:沒有`attr.sw.solvers`要求的步驟仍然與此機群相容,並且可以排程至該機群。
**注意**
自訂屬性和主機需求路由工作。它們不是存取控制。主機需求由提交任務的任何人在任務範本中設定,宣告屬性的機群仍然接受未提及的步驟。若要為工作者預留敏感內容,請將他們放在自己的機群中,並將該機群僅與核准的佇列建立關聯。如需詳細資訊,請參閱[存取控制和工作者選擇](#jobs-scheduling-access-control)及[使用陣列、機群和佇列隔離工作負載](farm-structure.md)。
如需在建立機群時設定自訂功能的詳細資訊,請參閱 [建立客戶受管機群](create-a-cmf.md)。
### GPU 記憶體報告
當您為需要特定每個 GPU VRAM 閾值的 GPU 密集型工作負載設定機群時,請了解工作者代理程式如何報告 GPU 記憶體。
Deadline Cloud 工作者代理程式會將工作者上所有 GPUs *的最低* GPU 記憶體報告至 `amount.worker.gpu.memory`,而不是總和。此行為可確保需要特定每個 GPU VRAM 數量的任務會路由至每個 GPU 符合該要求的工作者。
例如,如果工作者有兩個 GPUs,分別具有 24 GiB 和 48 GiB 的 VRAM,工作者代理程式會將 24 GiB 報告為 GPU 記憶體值。
在機群層級,將`acceleratorTotalMemoryMiB`最低設定為機群中任何工作者保證擁有的最低每個 GPU VRAM。
### 每個工作者的功能
當您需要在不影響排程決策的情況下追蹤個別工作者的操作狀態時,請使用每個工作者的功能。例如,您可以標記工作者以進行維護、追蹤軟體推出狀態,或記錄運作狀態檢查指標。
您可以使用 `UpdateWorker` API 操作在個別工作者上設定功能。每個工作者的功能*不會*用作排程合約。排程器只會針對機群層級`workerCapabilities`宣告評估相容性。
`GetWorker` 和 `ListWorkers`操作不會傳回透過 設定的工作者功能`UpdateWorker`。
如需詳細資訊,請參閱*《截止日期雲端 API 參考*》中的 [UpdateWorker](https://docs.aws.amazon.com/deadline-cloud/latest/APIReference/API_UpdateWorker.html)。
### 存取控制和工作者選擇
截止日期 雲端會將誰可以使用資源與任務執行所在的資源分開。IAM 政策和 AWS IAM Identity Center 使用者和群組成員資格控制誰可以檢視、提交和管理陣列、佇列或機群。佇列機群關聯和主機需求會控制執行每個任務的工作者。
機群的群組成員資格會授予人員在監視器中檢視和管理該機群的存取權。成員資格不會將任務路由到機群,也不會讓任務停止。若要將工作導向或移出機群,請使用佇列機群關聯。
主機需求是任務範本的一部分,因此任何提交任務的人員都會選擇它們。它們將工作路由到有能力的機群,而且它們不是存取控制。佇列機群關聯是強制執行點:無論步驟的主機需求為何,服務只會將步驟排程至與任務佇列相關聯的機群。若要讓限制的機群保持未經授權的工作,請將機群僅與限制的佇列建立關聯,並控制誰可以提交到這些佇列。如需佇列與共用工作者的機群之間安全界限的詳細資訊,請參閱[使用陣列、機群和佇列隔離工作負載](farm-structure.md)。
## 機群擴展
當任務指派給相容的服務受管機群時,機群會自動擴展。機群中的工作者數量會根據機群可執行的任務數量而變更。
當任務指派給客戶管理的機群時,工作者可能已經存在,或者可以使用事件型自動擴展來建立。如需詳細資訊,請參閱《Amazon EC2 Auto Scaling 使用者指南》中的[使用 EventBridge 來處理自動擴展事件](https://docs.aws.amazon.com/autoscaling/ec2/userguide/automating-ec2-auto-scaling-with-eventbridge.html)。 *Amazon EC2 Auto Scaling *
## 工作階段
任務中的任務分為一或多個工作階段。工作者會執行工作階段來設定環境、執行任務,然後銷毀環境。每個工作階段都由工作者必須採取的一或多個動作組成。
當工作者完成區段動作時,可以將其他工作階段動作傳送給工作者。工作者會在工作階段中重複使用現有的環境和任務附件,以更有效率的方式完成任務。
在服務受管機群工作者上,工作階段目錄會在工作階段結束後刪除,但在工作階段之間保留其他目錄。此行為可讓您針對可在多個工作階段間重複使用的資料實作快取策略。若要快取工作階段之間的資料,請將資料存放在執行任務之使用者的主目錄下。例如,Conda 套件會快取在Windows工作者和`/home/job-user/.conda-pkgs`Linux工作者`C:\Users\job-user\.conda-pkgs`上的 的任務使用者主目錄下。在工作者關閉之前,這些資料仍然可用。
任務附件是由做為截止日期雲端 CLI 任務套件一部分的提交者建立。您也可以使用 `create-job` AWS CLI 命令的 `--attachments`選項來建立任務附件。環境定義在兩個位置:連接到特定佇列的佇列環境,以及任務範本中定義的任務和步驟環境。
有四種工作階段動作類型:
+ `syncInputJobAttachments` – 將輸入任務附件下載至工作者。
+ `envEnter` – 執行環境`onEnter`的動作。
+ `taskRun` – 執行任務`onRun`的動作。
+ `envExit` – 執行環境`onExit`的動作。
下列任務範本具有步驟環境。它具有設定步驟環境`onEnter`的定義、定義要執行之任務`onRun`的定義,以及縮減步驟環境`onExit`的定義。為此任務建立的工作階段將包含 `envEnter`動作、一或多個`taskRun`動作,然後包含 `envExit`動作。
```
name: Sample Job with Maya Environment
specificationVersion: jobtemplate-2023-09
steps:
- name: Maya Step
stepEnvironments:
- name: Maya
description: Runs Maya in the background.
script:
embeddedFiles:
- name: initData
filename: init-data.yaml
type: TEXT
data: |
scene_file: MyAwesomeSceneFile
renderer: arnold
camera: persp
actions:
onEnter:
command: MayaAdaptor
args:
- daemon
- start
- --init-data
- file://{{Env.File.initData}}
onExit:
command: MayaAdaptor
args:
- daemon
- stop
parameterSpace:
taskParameterDefinitions:
- name: Frame
range: 1-5
type: INT
script:
embeddedFiles:
- name: runData
filename: run-data.yaml
type: TEXT
data: |
frame: {{Task.Param.Frame}}
actions:
onRun:
command: MayaAdaptor
args:
- daemon
- run
- --run-data
- file://{{ Task.File.runData }}
```
### 工作階段動作管道
工作階段動作管道可讓排程器將多個工作階段動作預先指派給工作者。然後,工作者可以依序執行這些動作,減少或消除任務之間的閒置時間。
若要建立初始指派,排程器會建立具有一個任務的工作階段、工作者完成任務,然後排程器會分析任務持續時間以判斷未來的指派。
為了讓排程器有效,有任務持續時間規則。對於一分鐘以內的任務,排程器會使用 2 的動力成長模式。例如,對於 1 秒的任務,排程器會指派 2 個新任務,然後 4 個新任務,然後 8 個新任務。對於超過一分鐘的任務,排程器只會指派一個新任務,且管道會保持停用狀態。
若要計算管道大小,排程器會執行下列動作:
+ 使用已完成任務的平均任務持續時間
+ 旨在讓工作者保持忙碌一分鐘
+ 僅考慮相同工作階段中的任務
+ 不跨工作者共用持續時間資料
隨著工作階段動作繁衍,工作者會立即開始新的任務,而且排程器請求之間沒有等待時間。它也為長時間執行的程序提供更高的工作者效率和更好的任務分佈。
此外,如果有新的較高優先順序任務可用,工作者將在目前的工作階段結束之前完成所有先前指派的工作,並指派來自較高優先順序任務的新工作階段。
## 步驟相依性
Deadline Cloud 支援在步驟之間定義相依性,讓一個步驟等待另一個步驟完成再開始。您可以為步驟定義多個相依性。在其所有相依性完成之前,不會排程具有相依性的步驟。
如果任務範本定義循環相依性,則會拒絕任務,並將任務狀態設定為 `CREATE_FAILED`。
下列任務範本會建立具有兩個步驟的任務。 `StepB` 取決於 `StepA`。 `StepB`只會在 `StepA` 成功完成之後執行。
建立任務後, `StepA` 會處於 `READY` 狀態,並`StepB`處於 `PENDING` 狀態。`StepA` 完成後, `StepB`會移至 `READY` 狀態。如果 `StepA` 失敗,或`StepA`如果 已取消,則 `StepB`會移至 `CANCELED` 狀態。
您可以設定多個步驟的相依性。例如,如果 同時`StepC`取決於 `StepA`和 `StepB`,則在另外兩個步驟完成之前, `StepC`不會開始。
步驟相依性有下列限制:
+ **每個步驟的相依性** – 步驟最多可依賴 128 個其他步驟。
+ **每個步驟的取用**者 – 最多 32 個其他步驟可以取決於單一步驟。
```
name: Step-Step Dependency Test
specificationVersion: 'jobtemplate-2023-09'
steps:
- name: A
script:
actions:
onRun:
command: bash
args: ['{{ Task.File.run }}']
embeddedFiles:
- name: run
type: TEXT
data: |
#!/bin/env bash
set -euo pipefail
sleep 1
echo Task A Done!
- name: B
dependencies:
- dependsOn: A # This means Step B depends on Step A
script:
actions:
onRun:
command: bash
args: ['{{ Task.File.run }}']
embeddedFiles:
- name: run
type: TEXT
data: |
#!/bin/env bash
set -euo pipefail
sleep 1
echo Task B Done!
```