本文為英文版的機器翻譯版本,如內容有任何歧義或不一致之處,概以英文版為準。
# 使用 AWS Glue 可觀測性指標進行監控
**注意**
AWS Glue 可觀測性指標可在 AWS Glue 4.0 及更新版本上使用。
使用 AWS Glue 可觀測性指標針對 Apache Spark 任務產生 AWS Glue 內部所發生之事件的深入解析,以改善問題的分類和分析。可觀測性指標能透過 Amazon CloudWatch 儀表板以視覺化呈現,並可用來協助執行錯誤的根本原因分析,以及診斷效能瓶頸。您可以減少大規模偵錯問題所花費的時間,使您能夠專注於更快、更有效地解決問題。
AWS Glue 可觀測性提供以下四個群組中分類的 Amazon CloudWatch 指標:
+ **可靠性 (即錯誤類別)**:可輕鬆識別特定時間範圍內您可能想要解決之常見失敗原因。
+ **效能 (即偏態)**:識別效能瓶頸並套用調整技術。例如,當您因任務偏態而遇到效能降低時,您可能會想要啟用 Spark 調適性查詢執行,並微調偏斜聯結閾值。
+ **輸送量 (即每個來源/接收器輸送量)**:監控資料讀取和寫入的趨勢。您也可以設定異常的 Amazon CloudWatch 警示。
+ **資源使用率 (即工作者、記憶體和磁碟使用率)**:有效率地找出容量使用率低的任務。您可能會想要為這些任務啟用 AWS Glue 自動擴展。
## 開始使用 AWS Glue 可觀測性指標
**注意**
設會在 AWS Glue Studio 主控台中啟用新的指標。
**要在 AWS Glue Studio 中設定可觀測性指標:**
1. 登入 AWS Glue 主控台,然後從主控台功能表選擇 **ETL 任務**。
1. 按一下**您的任務**區段中的任務名稱,即可選擇任務。
1. 選擇 **Job details** (任務詳細資訊) 索引標籤。
1. 捲動至底部,然後選擇**進階屬性**,接著選擇**任務可觀測性指標**。
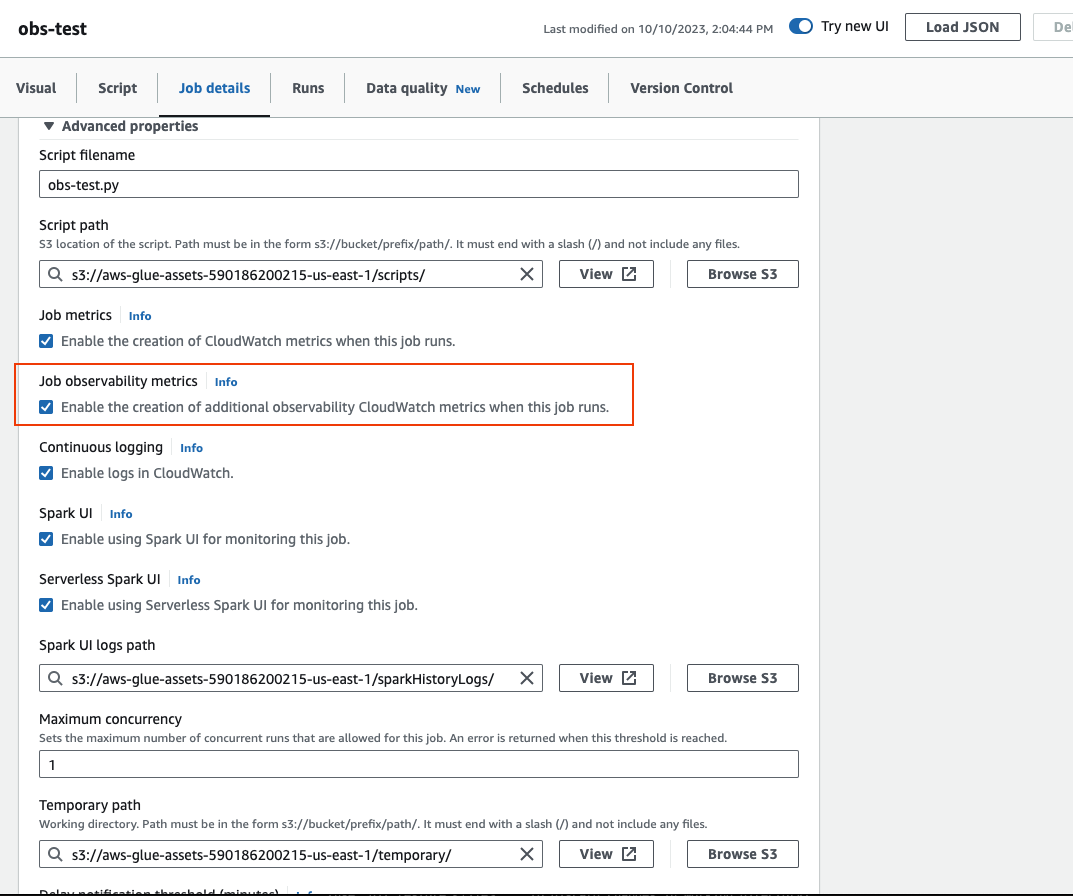
**若要使用 啟用AWS Glue可觀測性指標 AWS CLI:**
+ 將輸入 JSON 檔案中的下列鍵值新增至 `--default-arguments` 對應:
```
--enable-observability-metrics, true
```
## 使用 AWS Glue 可觀測性
由於可觀測性指標是透過 AWS Glue 提供 Amazon CloudWatch,因此您可以使用 Amazon CloudWatch 主控台 AWS CLI、 SDK 或 API 來查詢可觀測性指標資料點。請參閱[使用 Glue 可觀測性監控資源使用率以降低成本](https://aws.amazon.com/blogs/big-data/enhance-monitoring-and-debugging-for-aws-glue-jobs-using-new-job-observability-metrics/),了解何時使用 AWS Glue 可觀測性指標的範例使用案例。
### AWS Glue 在 Amazon CloudWatch 主控台中使用可觀測性
**若要在 Amazon CloudWatch 主控台中查詢和視覺化指標:**
1. 開啟 Amazon CloudWatch 主控台,然後選擇**所有指標**。
1. 在自訂命名空間下方,選取 **AWS Glue**。
1. 選擇**任務可觀測性指標、每個來源的可觀測性指標,或每個接收器的可觀測性指標**。
1. 搜尋特定的指標名稱、任務名稱、任務執行 ID,然後加以選取。
1. 在**圖形化指標**索引標籤下方,設定您偏好的統計資料、期間和其他選項。
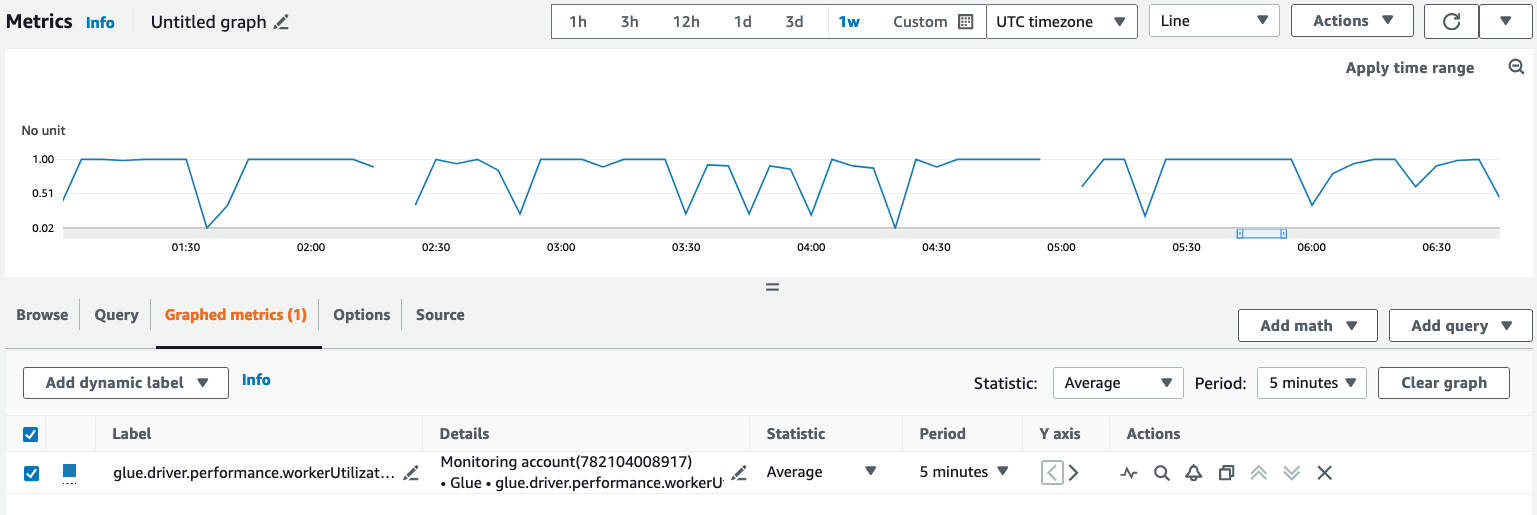
**使用 查詢可觀測性指標 AWS CLI:**
1. 建立指標定義 JSON 檔案並使用自己的值取代 `your-Glue-job-name` 和 `your-Glue-job-run-id`。
```
$ cat multiplequeries.json
[
{
"Id": "avgWorkerUtil_0",
"MetricStat": {
"Metric": {
"Namespace": "Glue",
"MetricName": "glue.driver.workerUtilization",
"Dimensions": [
{
"Name": "JobName",
"Value": ""
},
{
"Name": "JobRunId",
"Value": ""
},
{
"Name": "Type",
"Value": "gauge"
},
{
"Name": "ObservabilityGroup",
"Value": "resource_utilization"
}
]
},
"Period": 1800,
"Stat": "Minimum",
"Unit": "None"
}
},
{
"Id": "avgWorkerUtil_1",
"MetricStat": {
"Metric": {
"Namespace": "Glue",
"MetricName": "glue.driver.workerUtilization",
"Dimensions": [
{
"Name": "JobName",
"Value": ""
},
{
"Name": "JobRunId",
"Value": ""
},
{
"Name": "Type",
"Value": "gauge"
},
{
"Name": "ObservabilityGroup",
"Value": "resource_utilization"
}
]
},
"Period": 1800,
"Stat": "Minimum",
"Unit": "None"
}
}
]
```
1. 執行 `get-metric-data` 命令:
```
$ aws cloudwatch get-metric-data --metric-data-queries file: //multiplequeries.json \
--start-time '2023-10-28T18: 20' \
--end-time '2023-10-28T19: 10' \
--region us-east-1
{
"MetricDataResults": [
{
"Id": "avgWorkerUtil_0",
"Label": "",
"Timestamps": [
"2023-10-28T18:20:00+00:00"
],
"Values": [
0.06718750000000001
],
"StatusCode": "Complete"
},
{
"Id": "avgWorkerUtil_1",
"Label": "",
"Timestamps": [
"2023-10-28T18:50:00+00:00"
],
"Values": [
0.5959183673469387
],
"StatusCode": "Complete"
}
],
"Messages": []
}
```
## 可觀測性指標
AWS Glue 可觀測性設定檔並 Amazon CloudWatch 每 30 秒將下列指標傳送至 ,其中一些指標會顯示在AWS Glue Studio任務執行監控頁面中。
| 指標 | 說明 | Category |
| --- | --- | --- |
| glue.driver.skewness.stage | 指標類別:job\_performance
Spark 階段執行偏態:此指標表示特定階段中最大任務持續時間與此階段中的中等任務持續時間相比較有多長。其會擷取執行偏態,此偏態可能是由輸入資料偏態或轉換 (例如,偏斜聯結) 引起。此指標的值落在 [0, infinity[ 的範圍內,其中 0 表示該階段所有任務中,任務執行時間的最大值與中位數的比率小於特定階段偏態因子。預設階段偏態因子為「5」,可透過 spark conf 覆寫此值:spark.metrics.conf.driver.source.glue.jobPerformance.skewnessFactor
階段偏態值為 1 表示比率是階段偏態因子的兩倍。
階段偏態的值會每 30 秒更新一次,可反映目前的偏態。階段結束時的值會反映最後階段偏態。
此階段層級指標用於計算任務層級指標 `glue.driver.skewness.job`。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量),以及 ObservabilityGroup (job\_performance)
有效的統計資料:平均值、最大值、最小值、百分位數
單位:計數 | job\_performance |
| glue.driver.skewness.job | 指標類別:job\_performance
任務偏態是所有階段的加權偏態的最大值。階段偏態 (glue.driver.skewness.stage) 使用階段持續時間加權。這是為了避免以下極端情況,即相對於其他階段,嚴重偏斜的階段實際執行時間很短 (因此其偏態對整體作業效能影響不大,不值得費力嘗試解決其偏態)。
此指標會在每個階段完成時更新,因此最後一個值會反映實際的整體作業偏態。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量),以及 ObservabilityGroup (job\_performance)
有效的統計資料:平均值、最大值、最小值、百分位數
單位:計數 | job\_performance |
| glue.succeed.ALL | 指標類別:錯誤
成功的作業執行總數,可完成失敗類別的圖片
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計數),以及 ObservabilityGroup (錯誤)
有效的統計資料:總和
單位:計數 | error |
| glue.error.ALL | 指標類別:錯誤
作業執行錯誤總數,可完成失敗類別的圖片
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計數),以及 ObservabilityGroup (錯誤)
有效的統計資料:總和
單位:計數 | error |
| glue.error.[error category] | 指標類別:錯誤
這實際上是一組指標,只有在作業執行失敗時才會更新。錯誤分類有助於分類和偵錯。當作業執行失敗時,會將造成失敗的錯誤分類,並將對應的錯誤類別指標設為 1。這有助於針對所有作業錯誤分析執行隨著時間變化的失敗分析,以找出最常見的失敗類別並開始解決這些問題。AWS Glue 有 28 個錯誤類別,包括 OUT\_OF\_MEMORY (驅動程式和執行程式)、PERMISSION、SYNTAX 和 THROTTLING 錯誤類別。錯誤類別還包括 COMPILATION、LAUNCH 和 TIMEOUT 錯誤類別。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計數),以及 ObservabilityGroup (錯誤)
有效的統計資料:總和
單位:計數 | error |
| glue.driver.workerUtilization | 指標類別:resource\_utilization
實際使用的已配置工作者百分比。如果不理想,自動擴展可以有所助益。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量),以及 ObservabilityGroup (resource\_utilization)
有效的統計資料:平均值、最大值、最小值、百分位數
單位:百分比 | resource\_utilization |
| glue.driver.memory.heap.[available \| used] | 指標類別:resource\_utilization
在作業執行期間,驅動程式可用/已用的堆積記憶體。這有助於了解記憶體使用量趨勢,特別是隨著時間的推移,除了對記憶體相關的失敗進行偵錯,還有助於避免潛在的失敗。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量),以及 ObservabilityGroup (resource\_utilization)
有效的統計資料:平均值
單位:位元組 | resource\_utilization |
| glue.driver.memory.heap.used.percentage | 指標類別:resource\_utilization
在作業執行期間,驅動程式已用的 (%) 堆積記憶體。這有助於了解記憶體使用量趨勢,特別是隨著時間的推移,除了對記憶體相關的失敗進行偵錯,還有助於避免潛在的失敗。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量),以及 ObservabilityGroup (resource\_utilization)
有效的統計資料:平均值
單位:百分比 | resource\_utilization |
| glue.driver.memory.non-heap.[available \| used] | 指標類別:resource\_utilization
在作業執行期間,驅動程式可用/已用的非堆積記憶體。這有助於了解記憶體使用量趨勢,特別是隨著時間的推移,除了對記憶體相關的失敗進行偵錯,還有助於避免潛在的失敗。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量),以及 ObservabilityGroup (resource\_utilization)
有效的統計資料:平均值
單位:位元組 | resource\_utilization |
| glue.driver.memory.non-heap.used.percentage | 指標類別:resource\_utilization
在作業執行期間,驅動程式已用的 (%) 非堆積記憶體。這有助於了解記憶體使用量趨勢,特別是隨著時間的推移,除了對記憶體相關的失敗進行偵錯,還有助於避免潛在的失敗。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量),以及 ObservabilityGroup (resource\_utilization)
有效的統計資料:平均值
單位:百分比 | resource\_utilization |
| glue.driver.memory.total.[available \| used] | 指標類別:resource\_utilization
在作業執行期間,驅動程式可用/已用的記憶體總量。這有助於了解記憶體使用量趨勢,特別是隨著時間的推移,除了對記憶體相關的失敗進行偵錯,還有助於避免潛在的失敗。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量),以及 ObservabilityGroup (resource\_utilization)
有效的統計資料:平均值
單位:位元組 | resource\_utilization |
| glue.driver.memory.total.used.percentage | 指標類別:resource\_utilization
在作業執行期間,驅動程式已用的 (%) 記憶體總量。這有助於了解記憶體使用量趨勢,特別是隨著時間的推移,除了對記憶體相關的失敗進行偵錯,還有助於避免潛在的失敗。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量),以及 ObservabilityGroup (resource\_utilization)
有效的統計資料:平均值
單位:百分比 | resource\_utilization |
| glue.ALL.memory.heap.[available \| used] | 指標類別:resource\_utilization
執行程式可用/已用的堆積記憶體。ALL 表示所有執行程式。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量),以及 ObservabilityGroup (resource\_utilization)
有效的統計資料:平均值
單位:位元組 | resource\_utilization |
| glue.ALL.memory.heap.used.percentage | 指標類別:resource\_utilization
執行程式已用的 (%) 堆積記憶體。ALL 表示所有執行程式。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量),以及 ObservabilityGroup (resource\_utilization)
有效的統計資料:平均值
單位:百分比 | resource\_utilization |
| glue.ALL.memory.non-heap.[available \| used] | 指標類別:resource\_utilization
執行程式可用/已用的非堆積記憶體。ALL 表示所有執行程式。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量),以及 ObservabilityGroup (resource\_utilization)
有效的統計資料:平均值
單位:位元組 | resource\_utilization |
| glue.ALL.memory.non-heap.used.percentage | 指標類別:resource\_utilization
執行程式已用的 (%) 非堆積記憶體。ALL 表示所有執行程式。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量),以及 ObservabilityGroup (resource\_utilization)
有效的統計資料:平均值
單位:百分比 | resource\_utilization |
| glue.ALL.memory.total.[available \| used] | 指標類別:resource\_utilization
執行程式可用/已用的記憶體總量。ALL 表示所有執行程式。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量),以及 ObservabilityGroup (resource\_utilization)
有效的統計資料:平均值
單位:位元組 | resource\_utilization |
| glue.ALL.memory.total.used.percentage | 指標類別:resource\_utilization
執行程式已用的 (%) 記憶體總量。ALL 表示所有執行程式。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量),以及 ObservabilityGroup (resource\_utilization)
有效的統計資料:平均值
單位:百分比 | resource\_utilization |
| glue.driver.disk.[available\_GB \| used\_GB] | 指標類別:resource\_utilization
在作業執行期間,驅動程式可用/已用的磁碟空間。這有助於了解磁碟使用量趨勢,特別是隨著時間的推移,除了對磁碟空間不足相關的失敗進行偵錯,還有助於避免潛在的失敗。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量),以及 ObservabilityGroup (resource\_utilization)
有效的統計資料:平均值
單位:千兆位元組 (GB) | resource\_utilization |
| glue.driver.disk.used.percentage] | 指標類別:resource\_utilization
在作業執行期間,驅動程式可用/已用的磁碟空間。這有助於了解磁碟使用量趨勢,特別是隨著時間的推移,除了對磁碟空間不足相關的失敗進行偵錯,還有助於避免潛在的失敗。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量),以及 ObservabilityGroup (resource\_utilization)
有效的統計資料:平均值
單位:百分比 | resource\_utilization |
| glue.ALL.disk.[available\_GB \| used\_GB] | 指標類別:resource\_utilization
執行程式可用/已用的磁碟空間。ALL 表示所有執行程式。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量),以及 ObservabilityGroup (resource\_utilization)
有效的統計資料:平均值
單位:千兆位元組 (GB) | resource\_utilization |
| glue.ALL.disk.used.percentage | 指標類別:resource\_utilization
執行程式可用/已用/已用(%) 的磁碟空間。ALL 表示所有執行程式。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量),以及 ObservabilityGroup (resource\_utilization)
有效的統計資料:平均值
單位:百分比 | resource\_utilization |
| glue.driver.bytesRead | 指標類別:輸送量
此作業執行中每個輸入來源以及針對所有來源讀取的位元組數目。這有助於了解資料磁碟區及其隨時間的變化,進而幫助解決資料偏態等問題。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (儀表)、ObservabilityGroup (resource\_utilization),以及 Source (來源資料位置)
有效的統計資料:平均值
單位:位元組 | 輸送量 |
| glue.driver.[recordsRead \| filesRead] | 指標類別:輸送量
此作業執行中每個輸入來源以及針對所有來源讀取的記錄/檔案數目。這有助於了解資料磁碟區及其隨時間的變化,進而幫助解決資料偏態等問題。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (儀表)、ObservabilityGroup (resource\_utilization),以及 Source (來源資料位置)
有效的統計資料:平均值
單位:計數 | 輸送量 |
| glue.driver.partitionsRead | 指標類別:輸送量
此作業執行中每個 Amazon S3 輸入來源以及針對所有來源讀取的分割區數目。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (儀表)、ObservabilityGroup (resource\_utilization),以及 Source (來源資料位置)
有效的統計資料:平均值
單位:計數 | 輸送量 |
| glue.driver.bytesWrittten | 指標類別:輸送量
此作業執行中每個輸出接收器以及針對所有接收器寫入的位元組數目。這有助於了解資料磁碟區及其隨時間的演進,進而幫助解決處理偏態等問題。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量)、ObservabilityGroup (resource\_utilization),以及 Sink (接收器資料位置)
有效的統計資料:平均值
單位:位元組 | 輸送量 |
| glue.driver.[recordsWritten \| filesWritten] | 指標類別:輸送量
此任務執行中每個輸出接收器寫入的記錄/檔案數量,以及所有接收器。這有助於了解資料磁碟區及其隨時間的演進,進而幫助解決處理偏態等問題。
有效維度:JobName (AWS Glue 作業的名稱)、JobRunId (JobRun ID 或 ALL)、Type (計量)、ObservabilityGroup (resource\_utilization),以及 Sink (接收器資料位置)
有效的統計資料:平均值
單位:計數 | 輸送量 |
## 錯誤類別
| 錯誤類別 | 說明 |
| --- | --- |
| COMPILATION\_ERROR | 編譯 Scala 程式碼期間出現錯誤。 |
| CONNECTION\_ERROR | 連線到服務/遠端主機/資料庫服務等項目時出現錯誤。 |
| DISK\_NO\_SPACE\_ERROR | 驅動程式/執行程式的磁碟中沒有剩餘空間時出現錯誤。 |
| OUT\_OF\_MEMORY\_ERROR | 驅動程式/執行程式的記憶體中沒有剩餘空間時出現錯誤。 |
| IMPORT\_ERROR | 匯入相依性時出現錯誤。 |
| INVALID\_ARGUMENT\_ERROR | 輸入引數無效/非法時出現錯誤。 |
| PERMISSION\_ERROR | 缺少服務、資料等項目的許可時出現錯誤。 |
| RESOURCE\_NOT\_FOUND\_ERROR | 資料、位置等項目不存在時出現錯誤。 |
| QUERY\_ERROR | 因 Spark SQL 查詢執行而出現錯誤。 |
| SYNTAX\_ERROR | 指令碼中存在語法錯誤時出現錯誤。 |
| THROTTLING\_ERROR | 達到服務並行限制或超出服務配額限制時出現錯誤。 |
| DATA\_LAKE\_FRAMEWORK\_ERROR | 因 AWS Glue 原生支援的資料湖架構 (例如 Hudi、Iceberg 等) 而出現錯誤。 |
| UNSUPPORTED\_OPERATION\_ERROR | 進行不支援的操作時出現錯誤。 |
| RESOURCES\_ALREADY\_EXISTS\_ERROR | 要建立或新增的資源已存在時出現錯誤。 |
| GLUE\_INTERNAL\_SERVICE\_ERROR | 發生 AWS Glue 內部服務問題時出現錯誤。 |
| GLUE\_OPERATION\_TIMEOUT\_ERROR | AWS Glue 操作逾時時出現錯誤。 |
| GLUE\_VALIDATION\_ERROR | 無法驗證 AWS Glue 作業所需的值時出現錯誤。 |
| GLUE\_JOB\_BOOKMARK\_VERSION\_MISMATCH\_ERROR | 在相同的來源儲存貯體上執行同一個作業並同時寫入相同/不同的目的地 (並行數 > 1) 時出現錯誤 |
| LAUNCH\_ERROR | 在 AWS Glue 作業啟動階段出現錯誤。 |
| DYNAMODB\_ERROR | Amazon DynamoDB 服務發生一般錯誤。 |
| GLUE\_ERROR | 因 AWS Glue 服務而出現一般錯誤。 |
| LAKEFORMATION\_ERROR | AWS Lake Formation 服務出現一般錯誤。 |
| REDSHIFT\_ERROR | Amazon Redshift 服務出現一般錯誤。 |
| S3\_ERROR | 因 Amazon S3 服務而出現一般錯誤。 |
| SYSTEM\_EXIT\_ERROR | 一般系統結束錯誤。 |
| TIMEOUT\_ERROR | 作業因操作逾時而失敗時出現一般錯誤。 |
| UNCLASSIFIED\_SPARK\_ERROR | 因 Spark 而出現一般錯誤。 |
| UNCLASSIFIED\_ERROR | 預設錯誤類別。 |
## 限制
**注意**
必須將 `glueContext` 初始化才能發布指標。
在來源維度中,值可以是 Amazon S3 路徑或資料表名稱,具體取決於來源類型。此外,如果來源為 JDBC 且使用的是查詢選項,則會在來源維度中設定查詢字串。如果該值超過 500 個字元,則會修剪至 500 個字元以內。值的限制如下:
+ 非 ASCII 字元會被移除。
+ 如果來源名稱不包含任何 ASCII 字元,則會將該名稱轉換為 <非 ASCII 輸入>。
### 輸送量指標的限制和考量
+ 支援 DataFrame 和以 DataFrame 為基礎的 DynamicFrame (例如 JDBC,從 Amazon S3 上的 parquet 讀取),但不支援以 RDD 為基礎的 DynamicFrame (例如在 Amazon S3 讀取 csv、json)。從技術上來講,支援 Spark UI 上可見的所有讀取和寫入。
+ 如果資料來源是目錄資料表且格式為 JSON、CSV、文字或 Iceberg,則會發出 `recordsRead` 指標。
+ JDBC 和 Iceberg 資料表中不提供 `glue.driver.throughput.recordsWritten`、`glue.driver.throughput.bytesWritten` 和 `glue.driver.throughput.filesWritten` 指標。
+ 指標可能會延遲出現。如果任務在大約一分鐘內完成, Amazon CloudWatch 則指標中可能沒有輸送量指標。