Les traductions sont fournies par des outils de traduction automatique. En cas de conflit entre le contenu d'une traduction et celui de la version originale en anglais, la version anglaise prévaudra.
Configuration et personnalisation des requêtes pour les bases de connaissances gérées
Vous pouvez configurer et personnaliser la récupération, améliorant ainsi la pertinence des résultats. Par exemple, vous pouvez appliquer des filtres aux métadonnées des documents afin fields/attributes d'utiliser les documents les plus récemment mis à jour ou les documents dont la date de modification est récente.
Note
Toutes les configurations suivantes ne s'appliquent qu'aux sources de données non structurées.
Pour plus d’informations sur ces configurations dans la console ou l’API, sélectionnez l’une des rubriques suivantes :
Lorsque vous interrogez une base de connaissances, Amazon Bedrock renvoie par défaut jusqu’à cinq résultats dans la réponse. Chaque résultat correspond à un segment source.
Note
Le nombre réel de résultats dans la réponse peut être inférieur à la valeur numberOfResults spécifiée, car ce paramètre définit le nombre maximum de résultats à renvoyer. Si vous avez configuré le découpage hiérarchique pour votre stratégie de segmentation, le paramètre numberOfResults correspond au nombre de segments enfants que la base de connaissances extraira. Étant donné que les segments enfants qui partagent le même segment parent sont remplacés par le segment parent dans la réponse finale, le nombre de résultats renvoyés peut être inférieur au montant demandé.
Pour modifier le nombre maximum de résultats à renvoyer, choisissez l’onglet correspondant à votre méthode préférée, puis suivez les étapes :
Vous pouvez appliquer des filtres fields/attributes au document pour améliorer encore la pertinence des réponses. Vos sources de données peuvent inclure des métadonnées attributes/fields de document sur lesquelles filtrer et peuvent spécifier les champs à inclure dans les intégrations.
Considérations relatives à la base de connaissances gérée
Lorsque vous utilisez le filtrage des métadonnées avec une base de connaissances gérée :
-
Les filtres
startsWithdestringContainsmétadonnées et ne sont pas pris en charge. UtilisezequalsplutôtgreaterThanlesnotInopérateurslessThanin,, ou. -
Les opérateurs de plage (
greaterThan,greaterThanOrEqualslessThan, etlessThanOrEquals) acceptent soit un nombre, soit une valeur date-heure. Pour filtrer en fonction d'une date-heure, fournissez la valeur sous forme de chaîne au format date-heure ISO-8601 décalé. Utilisez le formulaire offset complet, par exemple2026-03-02T19:02:18Z. Les opérateurs de plage prennent en charge les valeurs de chaîne date-heure uniquement pour les bases de connaissances gérées. -
Pour les bases de connaissances personnalisées, les champs de métadonnées préfixés par
x-amz-bedrocksont réservés par le service. Pour les bases de connaissances entièrement gérées, les champs de métadonnées réservés utilisent un préfixe de soulignement (par exemple_source_uri,_data_source_id). Vous ne pouvez pas remplacer les champs de métadonnées réservés dans aucun type de base de connaissances.
Par exemple, « epoch_modification_time » représente le temps en secondes écoulé depuis le 1er janvier 1970 (UTC), date à laquelle le document a été mis à jour pour la dernière fois. Vous pouvez filtrer les données en fonction des plus récentes, pour lesquelles « epoch_modification_time » est supérieur à un certain nombre. Ces documents les plus récents peuvent être utilisés pour la requête.
Pour utiliser des filtres lorsque vous interrogez une base de connaissances, vérifiez que celle-ci répond aux exigences suivantes :
-
Lorsque vous configurez votre connecteur de source de données, la plupart des connecteurs explorent les principaux champs de métadonnées de vos documents. Si vous utilisez un compartiment Amazon S3 comme source de données, le compartiment doit inclure au moins un
fileName.extension.metadata.jsonpour le fichier ou le document auquel il est associé. Consultez Champs de métadonnées du document dans Configuration de la connexion pour plus d’informations sur la configuration du fichier de métadonnées. -
Si l'index vectoriel de votre base de connaissances se trouve dans une boutique vectorielle Amazon OpenSearch Serverless, vérifiez que l'index vectoriel est configuré avec le
faissmoteur. Si l’index vectoriel est configuré avec le moteurnmslib, vous devrez effectuer l’une des opérations suivantes :-
Créez une nouvelle base de connaissances dans la console et laissez Amazon Bedrock créer automatiquement un index vectoriel dans Amazon OpenSearch Serverless pour vous.
-
Créer un autre index vectoriel dans le magasin de vecteurs et sélectionner
faisscomme moteur Créer ensuite une base de connaissances et spécifier le nouvel index vectoriel
-
-
Si votre base de connaissances utilise un index vectoriel dans un compartiment vectoriel S3, vous ne pouvez pas utiliser les filtres
startsWithetstringContains. -
Si vous ajoutez des métadonnées à un index vectoriel existant dans un cluster de bases de données Amazon Aurora, nous vous recommandons de fournir le nom de champ de la colonne de métadonnées personnalisée afin de stocker toutes vos métadonnées dans une seule colonne. Lors de l’ingestion de données, cette colonne sera utilisée pour remplir toutes les informations contenues dans vos fichiers de métadonnées à partir de vos sources de données. Si vous choisissez de remplir ce champ, vous devez créer un index sur cette colonne.
-
Lorsque vous créez une nouvelle base de connaissances dans la console et que vous laissez Amazon Bedrock configurer votre base de données Amazon Aurora, il crée automatiquement une colonne unique pour vous et la remplit avec les informations de vos fichiers de métadonnées.
-
Lorsque vous choisissez de créer un autre index vectoriel dans le magasin de vecteurs, vous devez fournir le nom du champ de métadonnées personnalisé pour stocker les informations de vos fichiers de métadonnées. Si vous ne fournissez pas ce nom de champ, vous devez créer une colonne pour chaque attribut de métadonnées de vos fichiers et spécifier le type de données (texte, nombre ou booléen). Par exemple, si l’attribut
genreexiste dans votre source de données, vous devez ajouter une colonne nomméegenreet spécifiertextcomme type de données. Pendant l’ingestion, ces colonnes distinctes seront remplies avec les valeurs d’attribut correspondantes.
-
Si votre source de données contient des documents PDF et que vous utilisez Amazon OpenSearch Serverless ou Amazon Aurora pour votre boutique vectorielle, les bases de connaissances Amazon Bedrock généreront les numéros de page des documents et les stockeront dans des métadonnées field/attribute appelées x-amz-bedrock-kb-document-page-number. Notez que les numéros de page enregistrés dans un champ de métadonnées ne sont pas pris en charge si vous choisissez de ne pas segmenter vos documents.
Vous pouvez utiliser les opérateurs de filtrage suivants pour filtrer les résultats lorsque vous interrogez les éléments suivants :
| Opérateur | Console | Nom du filtre d’API | Types de données d’attribut pris en charge | Résultats filtrés |
|---|---|---|---|---|
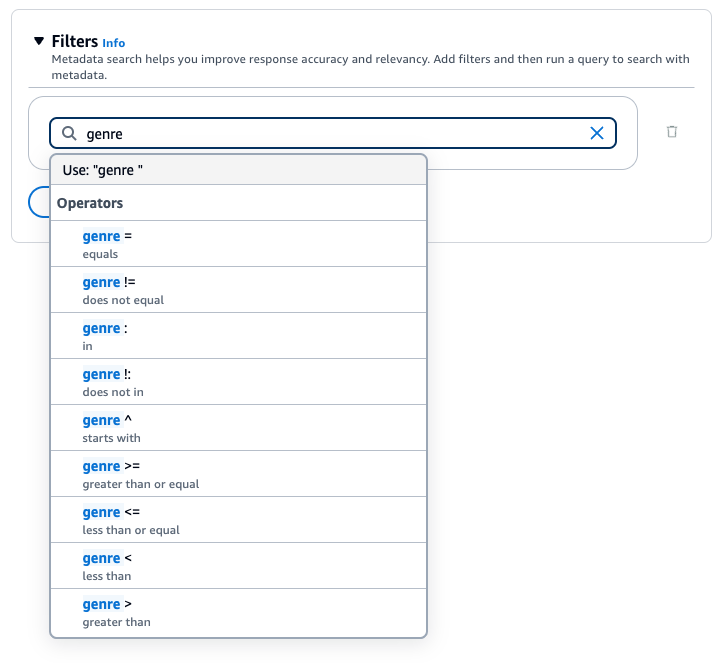
| Égal à | = | equals | chaîne, nombre, booléen | L'attribut correspond à la valeur que vous fournissez |
| Non égal à | != | notEquals | chaîne, nombre, booléen | L’attribut ne correspond pas à la valeur que vous fournissez |
| Supérieur à | > | Plus grand que | number | L’attribut est supérieur à la valeur que vous fournissez |
| Supérieur ou égal à | >= | plus grand ThanOrEquals | number | L’attribut est supérieur ou égal à la valeur que vous fournissez |
| Inférieur à | < | Inférieur à | number | L’attribut est inférieur à la valeur que vous fournissez |
| Inférieur ou égal à | <= | moins ThanOrEquals | number | L’attribut est inférieur ou égal à la valeur que vous fournissez |
| Dans | : | in | liste de chaînes | L'attribut se trouve dans la liste que vous fournissez (actuellement, il est préférable de le prendre en charge avec les magasins OpenSearch vectoriels Amazon Serverless et Neptune Analytics GraphRag) |
| Pas dans | !: | Pas dans | liste de chaînes | L'attribut ne figure pas dans la liste que vous fournissez (actuellement, il est préférable de le prendre en charge avec les boutiques OpenSearch vectorielles Amazon Serverless et Neptune Analytics GraphRag) |
| La chaîne contient | Non disponible | stringContains | chaîne | L’attribut doit être une chaîne. Le nom de l'attribut correspond à la clé et dont la valeur est une chaîne contenant la valeur que vous avez fournie en tant que sous-chaîne, ou une liste dont un membre contient la valeur que vous avez fournie en tant que sous-chaîne (actuellement, il est préférable de le prendre en charge avec la boutique vectorielle Amazon OpenSearch Serverless). Le magasin vectoriel GraphRag de Neptune Analytics prend en charge la variante de chaîne (mais pas la variante de liste de ce filtre). |
| La liste contient | Non disponible | listContains | chaîne | L’attribut doit être une liste de chaînes. Le nom de l'attribut correspond à la clé et sa valeur est une liste contenant la valeur que vous avez fournie en tant que membre (actuellement, il est préférable de prendre en charge les boutiques vectorielles Amazon OpenSearch Serverless). |
Pour combiner les opérateurs de filtrage, vous pouvez utiliser les opérateurs logiques suivants :
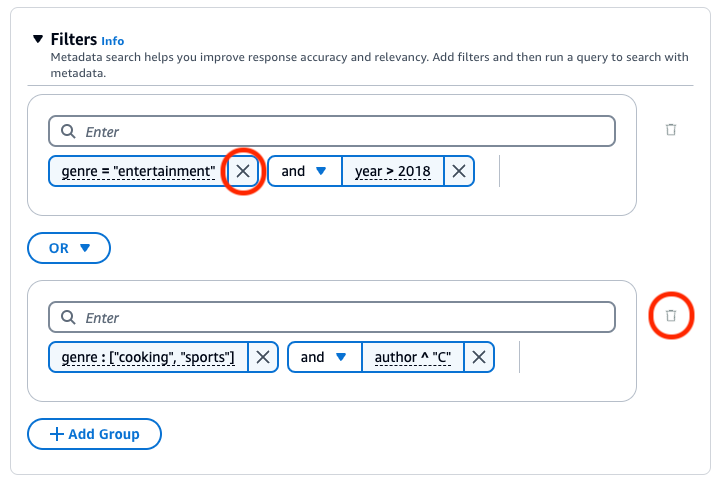
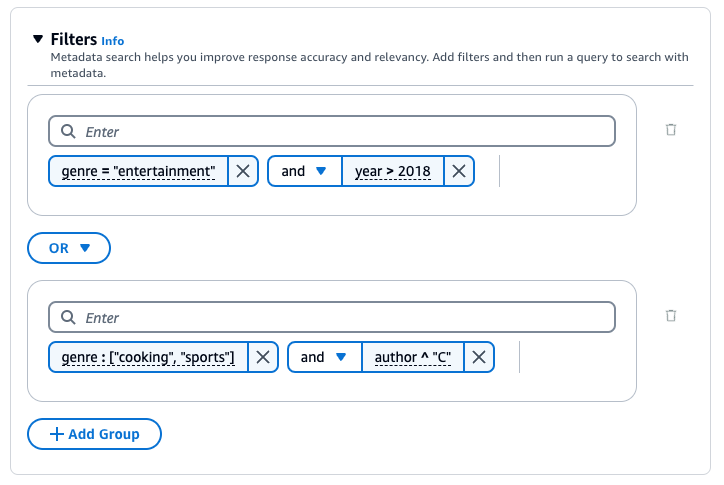
Pour apprendre à filtrer les résultats à l’aide de métadonnées, choisissez l’onglet correspondant à votre méthode préférée, puis suivez les étapes :
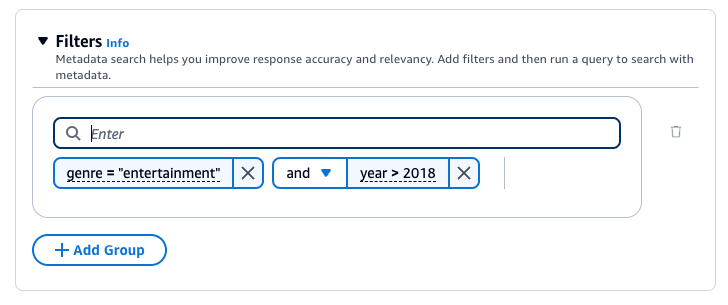
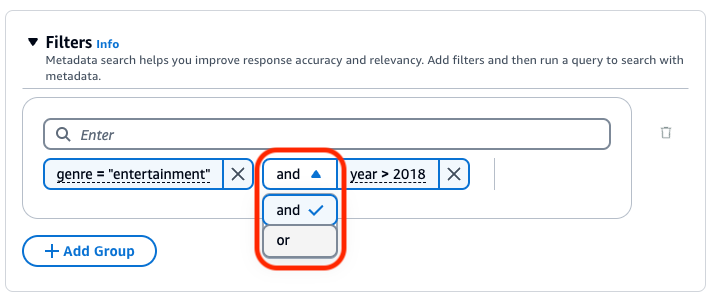
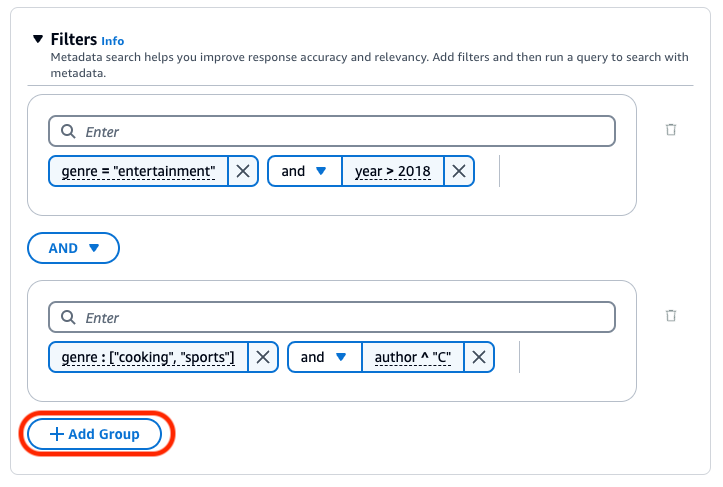
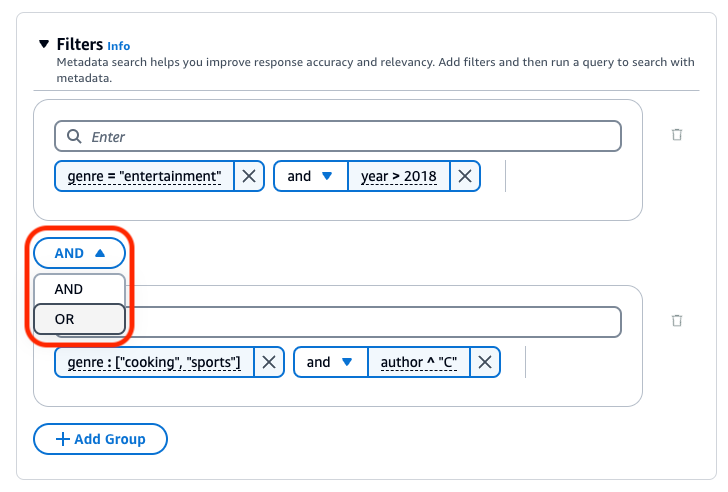
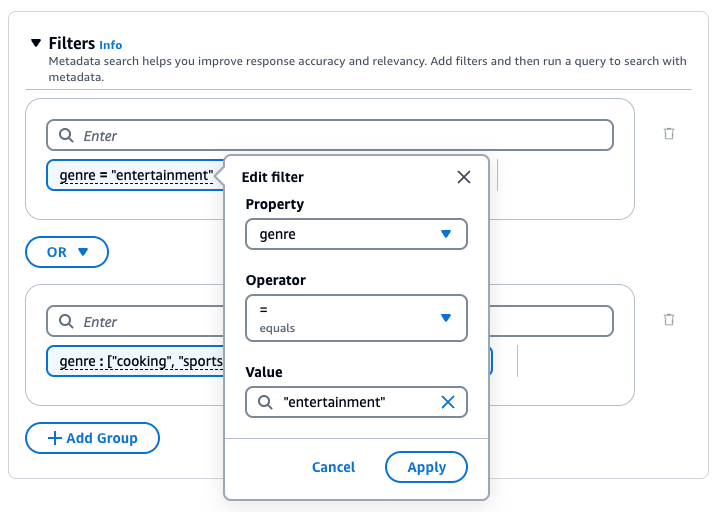
 ) en regard du groupe. Pour supprimer un filtre, choisissez l’icône de suppression (
 ) en regard du filtre.
Vous pouvez mettre en œuvre des mesures de protection pour votre base de connaissances, vos cas d’utilisation et les politiques d’IA responsables. Vous pouvez créer plusieurs barrières de protection adaptées à différents cas d’utilisation et les appliquer à de multiples conditions de demande et de réponse, afin d’offrir une expérience utilisateur cohérente et de standardiser les contrôles de sécurité dans votre base de connaissances. Vous pouvez configurer les sujets refusés pour interdire les sujets indésirables et les filtres de contenu pour bloquer le contenu préjudiciable dans les entrées et les réponses du modèle. Pour de plus amples informations, veuillez consulter Détection et filtrage des contenus préjudiciables à l’aide des barrières de protection Amazon Bedrock.
Note
L’utilisation de barrières de protection pour les bases de connaissances n’est actuellement pas prise en charge sur Claude 3, Sonnet et Haiku.
Pour les directives générales d’ingénierie de requête, consultez Concepts d’ingénierie de requête.
Choisissez l’onglet correspondant à votre méthode préférée, puis suivez les étapes :
Vous pouvez utiliser un modèle de reclassement pour reclasser les résultats d’une requête de la base de connaissances. Suivez les étapes de la console décrites dans Interrogation d’une base de connaissances et extraction des données. Lorsque vous ouvrez le volet Configurations, développez la section Reclassement. Sélectionnez un modèle de reclassement, mettez à jour les autorisations si nécessaire et modifiez les options supplémentaires. Entrez une invite et sélectionnez Exécuter pour tester les résultats après le reclassement.
