本文属于机器翻译版本。若本译文内容与英语原文存在差异,则一律以英文原文为准。
Amazon ECS 中基于 SQL 的数据处理
发布日期:2021 年 3 月 8 日 (图表历史)
该架构展示了如何使用容器化 ETL 框架 (ARC) 构建配置驱动、无代码提取转换加载 (ETL) 替代方案,该框架可简化和加速数据处理。https://arc.tripl.ai/
Amazon ECS 中基于 SQL 的数据处理
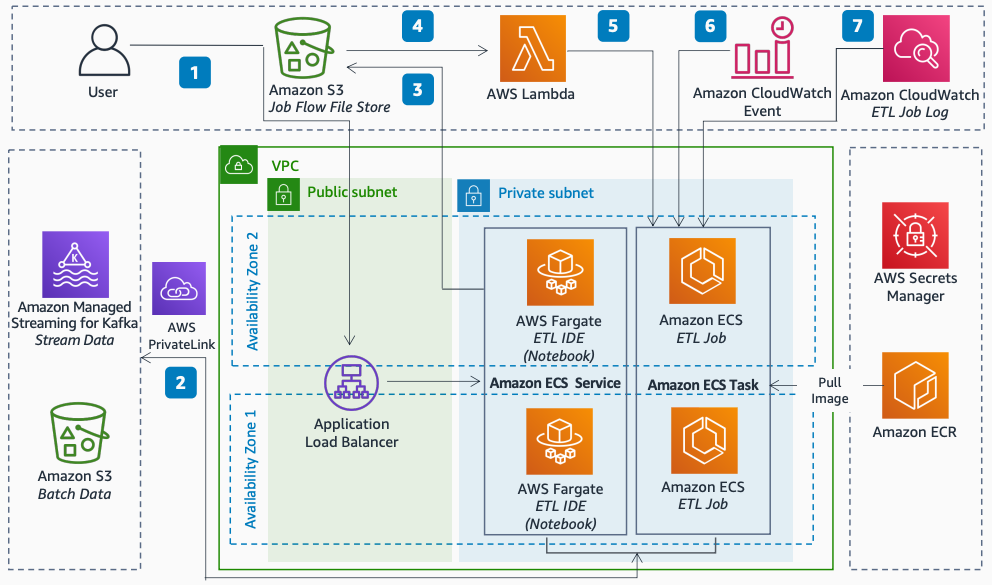
以下步骤描述了架构:
-
用户在交互式 ARC Jupyter Notebook 中基于 ARC 框架和 SQL 脚本创建 ETL 数据管道。该笔记本电脑在带有 AWS Fargate 的亚马逊 ECS 上运行。
-
笔记本和 ETL 任务通过 AWS PrivateLink 批处理和流式传输数据。ETL 进程和数据存储之间的流量不会离开亚马逊网络。
-
ARC Jupyter 笔记本生成任务流程配置 JSON 文件。用户通过 CI/CD 自动部署流程或手动将文件和 SQL 脚本上传到亚马逊简单存储服务。
-
Amazon S3 文件到达事件会触发一个AWS Lambda函数。
-
Lambda 函数启动 Amazon ECS 任务,以临时方式处理批量数据,或者在长时间运行的容器中持续处理流数据。每项任务都使用独立的计算资源。
-
Amazon E CloudWatch vents 使用 AWS Fargate 或 Amazon EC2 启动类型计划和编排常规 ARC ETL 任务和亚马逊 ECS 任务。
-
ARC ETL 任务为每个数据处理阶段生成粒度级别的应用程序日志。 CloudWatch 提供监控和警报功能。
延伸阅读
有关其他信息,请参阅以下资源:
图表历史
要获得有关此参考架构图更新的通知,请订阅 RSS 提要。
| 变更 | 说明 | 日期 |
|---|---|---|
初次发布 | 参考架构图首次发布。 | 2021 年 3 月 8 日 |
注意
要订阅 RSS 更新,必须为正在使用的浏览器启用 RSS 插件。
