Avis de fin de support : le 30 septembre 2027, le support d'Amazon DevOps Guru AWS prendra fin. Après le 30 septembre 2027, vous ne pourrez plus accéder à la console Amazon DevOps Guru ni aux ressources Amazon DevOps Guru. Pour plus d’informations, consultez Fin du support d'Amazon DevOps Guru.
Les traductions sont fournies par des outils de traduction automatique. En cas de conflit entre le contenu d'une traduction et celui de la version originale en anglais, la version anglaise prévaudra.
Visualisation des anomalies réactives
Dans un aperçu, vous pouvez consulter les anomalies relatives aux ressources Amazon RDS. Sur une page d'analyse réactive, dans la section Mesures agrégées, vous pouvez consulter une liste des anomalies avec les chronologies correspondantes. Certaines sections affichent également des informations sur les groupes de journaux et les événements liés aux anomalies. Les anomalies causales figurant dans un aperçu réactif ont chacune une page correspondante contenant des détails sur l'anomalie.
Visualisation de l'analyse détaillée d'une anomalie réactive du RDS
À ce stade, explorez l'anomalie pour obtenir l'analyse détaillée et les recommandations relatives à vos instances de bases de données Amazon RDS.
L'analyse détaillée n'est disponible que pour les instances de base de données Amazon RDS pour lesquelles Performance Insights est activé.
Pour accéder à la page des détails de l'anomalie
-
Sur la page d'aperçu, recherchez une métrique agrégée avec le type de ressource AWS/RDS.
-
Sélectionnez Afficher les détails.
La page des détails de l'anomalie s'affiche. Le titre commence par « Anomalie des performances de la base de données » et nomme la ressource show. La console utilise par défaut l'anomalie la plus grave, quel que soit le moment où elle s'est produite.
-
(Facultatif) Si plusieurs ressources sont concernées, choisissez-en une autre dans la liste en haut de la page.
Vous trouverez ci-dessous les descriptions des composants de la page de détails.
Vue d’ensemble des ressources
La section supérieure de la page de détails est intitulée Aperçu des ressources. Cette section résume l'anomalie de performance rencontrée par votre instance de base de données Amazon RDS.
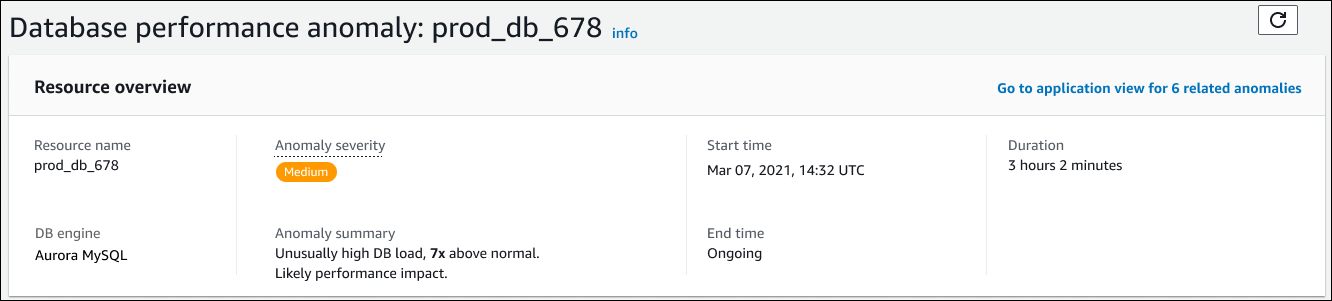
Cette section contient les champs suivants :
-
Nom de la ressource : nom de l'instance de base de données qui rencontre l'anomalie. Dans cet exemple, la ressource est nommée prod_db_678.
-
Moteur de base de données : nom de l'instance de base de données qui présente l'anomalie. Dans cet exemple, le moteur est Aurora MySQL.
-
Gravité de l'anomalie : mesure de l'impact négatif de l'anomalie sur votre instance. Les degrés de gravité possibles sont élevés , moyens et faibles.
-
Résumé des anomalies : bref résumé du problème. Un résumé typique est une charge de base de données anormalement élevée.
-
Heure de début et heure de fin : heure à laquelle l'anomalie a commencé et s'est terminée. Si l'heure de fin est En cours, l'anomalie persiste.
-
Durée : durée du comportement anormal. Dans cet exemple, l'anomalie est continue et se produit depuis 3 heures et 2 minutes.
Métrique principale
La section Métrique principale résume l'anomalie occasionnelle, qui est l'anomalie de niveau supérieur de l'aperçu. Vous pouvez considérer l'anomalie causale comme le problème général rencontré par votre instance de base de données.
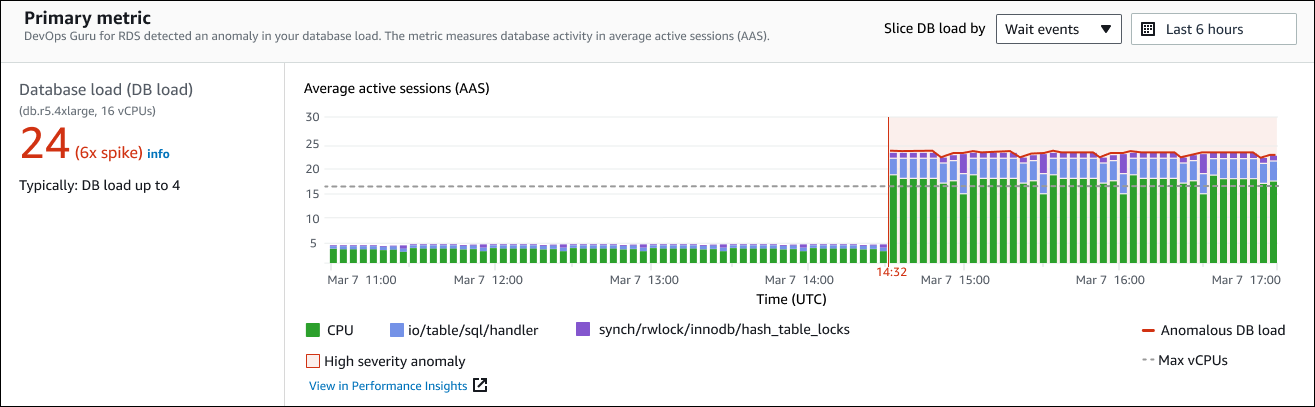
Le panneau de gauche fournit plus de détails sur le problème. Dans cet exemple, le résumé inclut les informations suivantes :
-
Charge de base de données (charge de base de données) : classification de l'anomalie en tant que problème de chargement de base de données. La métrique correspondante dans Performance Insights est
DBLoad. Cette métrique est également publiée sur Amazon CloudWatch. -
db.r5.4xlarge — Classe d'instance de base de données. Le nombre de vCPU, qui est de 16 dans cet exemple, correspond à la ligne pointillée du graphique AAS (Average active sessions).
-
24 (6x pic) — La charge de base de données, mesurée en sessions actives moyennes (AAS) pendant l'intervalle de temps indiqué dans l'aperçu. Ainsi, à tout moment pendant la période de l'anomalie, 24 sessions en moyenne étaient actives sur la base de données. La charge de base de données est 6 fois supérieure à la charge de base de données normale pour cette instance.
-
Typiquement : charge en dB jusqu'à 4 : valeur de référence de la charge en dB, mesurée en AAS, au cours d'une charge de travail typique. La valeur 4 signifie que, pendant les opérations normales, en moyenne 4 sessions ou moins sont actives sur la base de données à un moment donné.
Par défaut, le graphique de charge est découpé en fonction des événements d'attente. Cela signifie que pour chaque barre du graphique, la plus grande zone colorée représente l'événement d'attente qui contribue le plus à la charge totale de la base de données. Le graphique indique l'heure (en rouge) à laquelle le problème a commencé. Concentrez votre attention sur les événements d'attente qui occupent le plus de place dans la barre :
-
CPU -
IO:wait/io/sql/table/handler
Les événements d'attente précédents apparaissent plus que d'habitude pour cette base de données Aurora MySQL. Pour savoir comment ajuster les performances à l'aide d'événements d'attente dans Amazon Aurora, consultez Réglage avec des événements d'attente pour Aurora MySQL et Réglage avec des événements d'attente pour Aurora PostgreSQL dans le guide de l'utilisateur Amazon Aurora. Pour savoir comment ajuster les performances à l'aide d'événements d'attente dans RDS pour PostgreSQL, consultez la section Réglage à l'aide d'événements d'attente pour RDS pour PostgreSQL dans le guide de l'utilisateur Amazon RDS.
Métriques associées
La section Métriques associées répertorie les anomalies contextuelles, qui sont des résultats spécifiques au sein de l'anomalie causale. Ces résultats fournissent des informations supplémentaires sur les problèmes de performance.
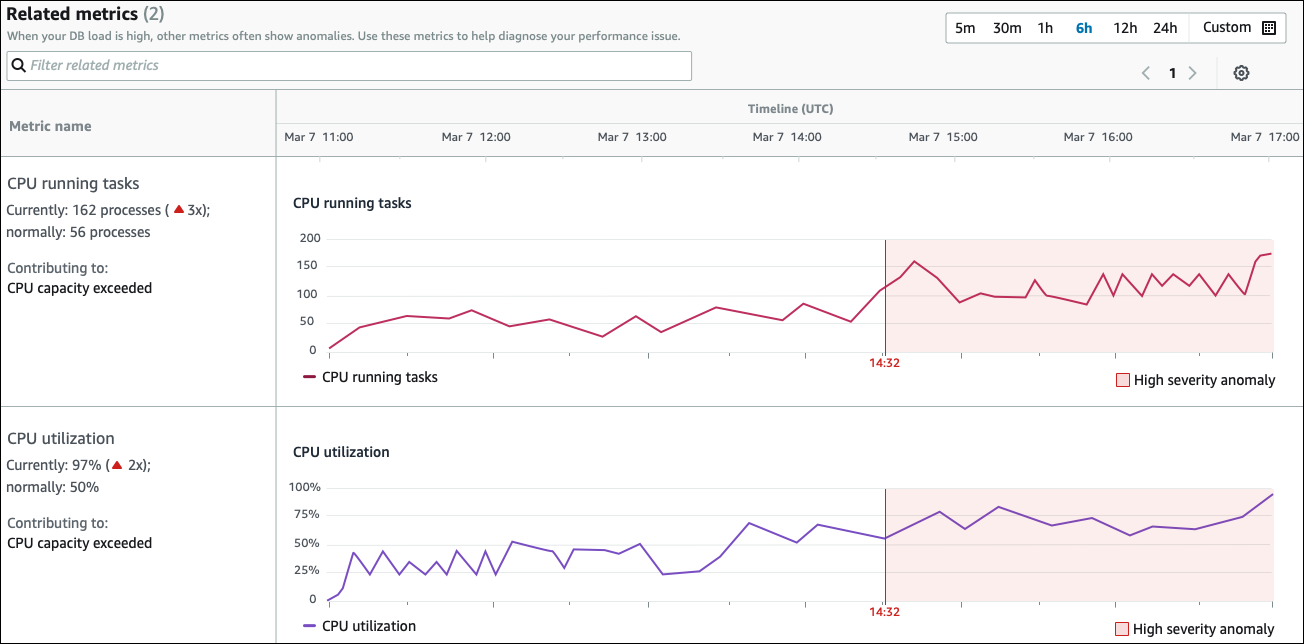
Le tableau des mesures associées comporte deux colonnes : nom des mesures et chronologie (UTC). Chaque ligne du tableau correspond à une métrique spécifique.
La première colonne de chaque ligne contient les informations suivantes :
-
Name— Le nom de la métrique. La première ligne identifie la métrique comme étant des tâches exécutées par le processeur. -
Actuellement : valeur actuelle de la métrique. Dans la première ligne, la valeur actuelle est de 162 processus (3x).
-
Normalement : référence de cette métrique pour cette base de données lorsqu'elle fonctionne normalement. DevOpsGuru for RDS calcule la base de référence comme la valeur du 95e percentile sur une semaine d'historique. La première ligne indique que 56 processus sont généralement exécutés sur le processeur.
-
Contribuant à : résultat associé à cette métrique. Dans la première ligne, la métrique des tâches en cours d'exécution du processeur est associée à l'anomalie de dépassement de la capacité du processeur.
La colonne Chronologie affiche un graphique linéaire pour la métrique. La zone ombrée indique l'intervalle de temps pendant lequel DevOps Guru for RDS a désigné le résultat comme étant de gravité élevée.
Analyse et recommandations
Alors que l'anomalie causale décrit le problème dans son ensemble, une anomalie contextuelle décrit un résultat spécifique qui nécessite une enquête. Chaque résultat correspond à un ensemble de mesures connexes.
Dans l'exemple suivant de section Analyse et recommandations, l'anomalie de charge DB élevée présente deux résultats.
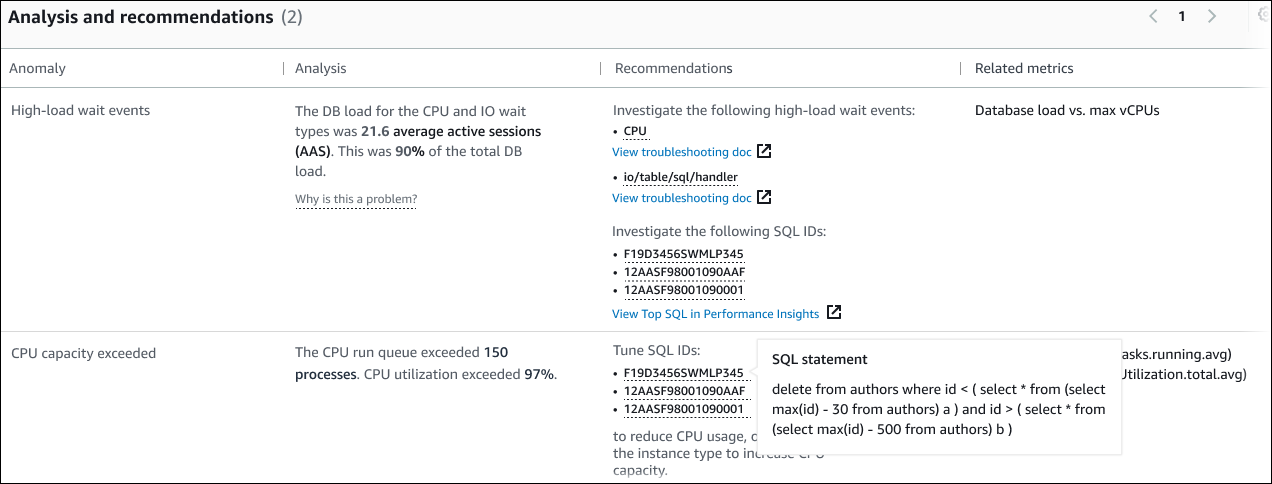
Cette table possède les colonnes suivantes :
-
Anomalie : description générale de cette anomalie contextuelle. Dans cet exemple, la première anomalie concerne les événements d'attente à charge élevée et la seconde est le dépassement de la capacité du processeur.
-
Analyse : explication détaillée de l'anomalie.
Dans la première anomalie, trois types d'attente contribuent à 90 % de la charge de la base de données. Dans la deuxième anomalie, la file d'attente d'exécution du processeur dépassait 150, ce qui signifie qu'à tout moment, plus de 150 sessions étaient en attente de temps processeur. Le taux d'utilisation du processeur était supérieur à 97 %, ce qui signifie que pendant la durée du problème, le processeur était occupé 97 % du temps. Ainsi, le processeur était presque continuellement occupé alors qu'en moyenne 150 sessions attendaient d'être exécutées sur le processeur.
-
Recommandations : réponse suggérée par l'utilisateur à l'anomalie.
Dans la première anomalie, DevOps Guru for RDS vous recommande d'étudier les événements d'attente
cpuetio/table/sql/handler. Pour savoir comment ajuster les performances de votre base de données en fonction de ces événements, consultez cpu io/table et/ou sql/handler dans le guide de l'utilisateur Amazon Aurora.Dans la deuxième anomalie, DevOps Guru for RDS vous recommande de réduire la consommation du processeur en ajustant trois instructions SQL. Vous pouvez passer la souris sur les liens pour voir le texte SQL.
-
Métriques associées : mesures qui fournissent des mesures spécifiques pour l'anomalie. Pour plus d'informations sur ces métriques, consultez la section Référence des métriques pour Amazon Aurora dans le Guide de l'utilisateur Amazon Aurora ou la référence des métriques pour Amazon RDS dans le Guide de l'utilisateur Amazon RDS.
Dans la première anomalie, DevOps Guru for RDS recommande de comparer la charge de la base de données au processeur maximum pour votre instance. Dans la deuxième anomalie, la recommandation est d'examiner la file d'attente d'exécution du processeur, l'utilisation du processeur et le taux d'exécution SQL.
