기계 번역으로 제공되는 번역입니다. 제공된 번역과 원본 영어의 내용이 상충하는 경우에는 영어 버전이 우선합니다.
관리형 지식 기반에 대한 쿼리 구성 및 사용자 지정
검색을 구성하고 사용자 지정하여 결과의 관련성을 더욱 개선할 수 있습니다. 예를 들어, 문서 메타데이터 필드/속성에 필터를 적용하여 가장 최근에 업데이트된 문서나 최근 수정 시간이 있는 문서를 사용하도록 할 수 있습니다.
참고
다음 구성은 모두 비정형 데이터 소스에만 적용됩니다.
콘솔 또는 API에서 이러한 구성이 어떻게 적용되는지 자세히 알아보려면 다음 주제를 살펴보세요.
지식 기반을 쿼리하면 Amazon Bedrock은 기본적으로 최대 5개의 결과를 반환합니다. 각 결과는 소스 청크에 해당합니다.
참고
이 파라미터는 반환할 최대 결과 수를 설정하므로 응답의 실제 결과 수는 지정된 numberOfResults 값보다 작을 수 있습니다. 청킹 전략에 대한 계층적 청킹을 구성한 경우 numberOfResults 파라미터는 지식 기반에서 검색할 하위 청크 수에 매핑됩니다. 동일한 상위 청크를 공유하는 하위 청크는 최종 응답에서 상위 청크로 대체되므로 반환되는 결과 수는 요청된 양보다 적을 수 있습니다.
반환할 최대 결과 수를 수정하려면 원하는 방법에 해당하는 탭을 선택하고 다음 단계를 따릅니다.
필터를 문서 필드/속성에 적용하여 응답의 관련성을 더욱 개선할 수 있습니다. 데이터 소스에는 필터링할 문서 메타데이터 속성/필드가 포함될 수 있으며 임베딩에 포함할 필드를 지정할 수 있습니다.
관리형 지식 기반 고려 사항
관리형 지식 기반에서 메타데이터 필터링을 사용하는 경우:
-
startsWith및stringContains메타데이터 필터는 지원되지 않습니다. 대신equals,greaterThan,lessThanin, 또는notIn연산자를 사용합니다. -
범위 연산자(
greaterThan,greaterThanOrEqualslessThan, 및lessThanOrEquals)는 숫자 또는 날짜-시간 값을 허용합니다. 날짜-시간을 기준으로 필터링하려면 값을 ISO-8601 오프셋 날짜-시간 형식의 문자열로 제공합니다. 와 같은 전체 오프셋 양식을 사용합니다2026-03-02T19:02:18Z. 범위 연산자는 관리형 지식 기반에 대해서만 날짜-시간 문자열 값을 지원합니다. -
사용자 지정 지식 기반의 경우 접두사가 인 메타데이터 필드는 서비스에 예약
x-amz-bedrock됩니다. 완전 관리형 지식 기반의 경우 예약된 메타데이터 필드는 밑줄 접두사(예: ,_source_uri_data_source_id)를 사용합니다. 두 지식 기반 유형 모두 예약된 메타데이터 필드를 재정의할 수 없습니다.
예를 들어 'epoch_modification_time'은 문서가 마지막으로 업데이트된 1970년 1월 1일(UTC) 이후 초 단위의 시간을 나타냅니다. 'epoch_modification_time'이 특정 수보다 큰 최신 데이터를 기준으로 필터링할 수 있습니다. 이러한 최신 문서를 쿼리에 사용할 수 있습니다.
지식 기반을 쿼리할 때 필터를 사용하려면 지식 기반이 다음 요구 사항을 충족하는지 확인합니다.
-
데이터 소스 커넥터를 구성할 때 대부분의 커넥터는 문서의 기본 메타데이터 필드를 크롤링합니다. Amazon S3 버킷을 데이터 소스로 사용하는 경우, 버킷에는 연결된 파일 또는 문서에 대해 하나 이상의
fileName.extension.metadata.json이 포함되어야 합니다. 메타데이터 파일 구성에 대한 자세한 내용은 연결 구성의 문서 메타데이터 필드를 참조하세요. -
지식 베이스의 벡터 인덱스가 Amazon OpenSearch Serverless 벡터 스토어에 있는 경우, 벡터 인덱스가
faiss엔진으로 구성되어 있는지 확인합니다. 벡터 인덱스가nmslib엔진으로 구성되어 있다면 다음 중 하나를 수행해야 합니다.-
콘솔에서 새 지식 기반을 만들고 Amazon Bedrock이 Amazon OpenSearch Serverless에서 벡터 인덱스를 자동으로 만들도록 합니다.
-
벡터 스토어에서 또 다른 벡터 인덱스를 만들고 엔진으로
faiss를 선택합니다. 그런 다음 새 지식 기반을 만들고 새 벡터 인덱스를 지정합니다.
-
-
지식 기반이 S3 벡터 버킷에서 벡터 인덱스를 사용하는 경우
startsWith및stringContains필터를 사용할 수 없습니다. -
Amazon Aurora 데이터베이스 클러스터의 기존 벡터 인덱스에 메타데이터를 추가하는 경우 사용자 지정 메타데이터 열의 필드 이름을 제공하여 모든 메타데이터를 단일 열에 저장하는 것이 좋습니다. 데이터 수집 중에 이 열은 데이터 소스의 메타데이터 파일에 있는 모든 정보를 채우는 데 사용됩니다. 이 필드를 제공하기로 선택한 경우 이 열에 인덱스를 생성해야 합니다.
-
콘솔에서 새 지식 기반을 생성하고 Amazon Bedrock이 Amazon Aurora 데이터베이스를 구성하도록 하면 자동으로 단일 열을 생성하고 메타데이터 파일의 정보로 채웁니다.
-
벡터 스토어에서 다른 벡터 인덱스를 생성하도록 선택한 경우 메타데이터 파일의 정보를 저장할 사용자 지정 메타데이터 필드 이름을 제공해야 합니다. 이 필드 이름을 제공하지 않는 경우 파일의 각 메타데이터 속성에 대한 열을 생성하고 데이터 유형(텍스트, 숫자 또는 부울)을 지정해야 합니다. 예를 들어,
genre속성이 데이터 소스에 있는 경우genre라는 열을 추가하고text를 데이터 유형으로 지정합니다. 수집 과정에서 이러한 별도의 열은 해당 속성 값으로 채워집니다.
-
데이터 소스에 PDF 문서가 있고 벡터 스토어에 Amazon OpenSearch Serverless 또는 Amazon Aurora를 사용하는 경우: Amazon Bedrock 지식 기반은 문서 페이지 번호를 생성하고 이를 x-amz-bedrock-kb-document-page-number라는 메타데이터 필드/속성에 저장합니다. 문서에 청킹을 선택하지 않으면 메타데이터 필드에 저장된 페이지 번호가 지원되지 않습니다.
다음 필터링 연산자를 사용하여 쿼리에서 결과를 필터링할 수 있습니다.
| 연산자 | 콘솔 | API 필터 이름 | 지원되는 속성 데이터 유형 | 필터링 결과 |
|---|---|---|---|---|
| 같음 | = | 같음 | 문자열, 숫자, 부울 | 속성이 사용자가 제공한 값과 일치합니다. |
| 같지 않음 | != | notEquals | 문자열, 숫자, 부울 | 속성이 사용자가 제공한 값과 일치하지 않습니다. |
| 보다 큼 | > | greaterThan | number | 속성이 사용자가 제공한 값보다 큽니다. |
| 크거나 같음 | >= | greaterThanOrEquals | number | 속성이 사용자가 제공한 값보다 크거나 같습니다. |
| 보다 작음 | < | lessThan | number | 속성이 사용자가 제공한 값보다 작습니다. |
| 작거나 같음 | <= | lessThanOrEquals | number | 속성이 사용자가 제공한 값보다 작거나 같습니다. |
| 있음 | : | in | 문자열 목록 | 속성이 사용자가 제공한 목록에 있습니다(현재 Amazon OpenSearch Serverless 및 Neptune Analytics GraphRAG 벡터 스토어에서 가장 잘 지원됨) |
| 없음 | !: | notIn | 문자열 목록 | 속성이 사용자가 제공한 목록에 없습니다(현재 Amazon OpenSearch Serverless 및 Neptune Analytics GraphRAG 벡터 스토어에서 가장 잘 지원됨) |
| 문자열 나열 | 사용할 수 없음 | stringContains | 문자열 | 속성은 문자열이어야 합니다. 속성 이름은 키와 일치하며 값이 하위 문자열로 제공한 값을 포함하는 문자열이거나 하위 문자열로 제공한 값을 포함하는 멤버가 있는 목록입니다(현재 Amazon OpenSearch Serverless 벡터 스토어에서 가장 잘 지원됨. Neptune Analytics GraphRAG 벡터 스토어는 문자열 변형을 지원하지만 이 필터의 목록 변형은 지원하지 않습니다). |
| 목록 나열 | 사용할 수 없음 | listContains | 문자열 | 속성은 반드시 문자열 목록이어야 합니다. 속성 이름은 키와 일치하며 값이 멤버 중 하나로 제공한 값이 포함된 목록입니다(현재 Amazon OpenSearch Serverless 벡터 스토어에서 가장 잘 지원됨). |
필터링 연산자를 결합하려면 다음 논리 연산자를 사용할 수 있습니다.
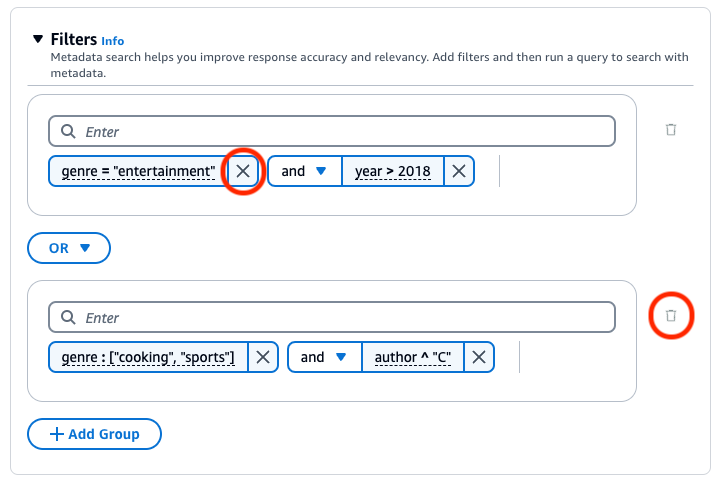
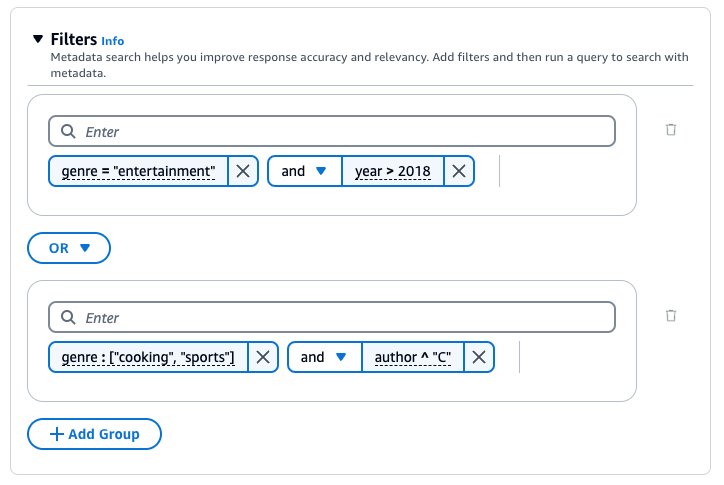
메타데이터를 사용하여 결과를 필터링하는 방법을 알아보려면 원하는 방법에 해당하는 탭을 선택하고 다음 단계를 따릅니다.
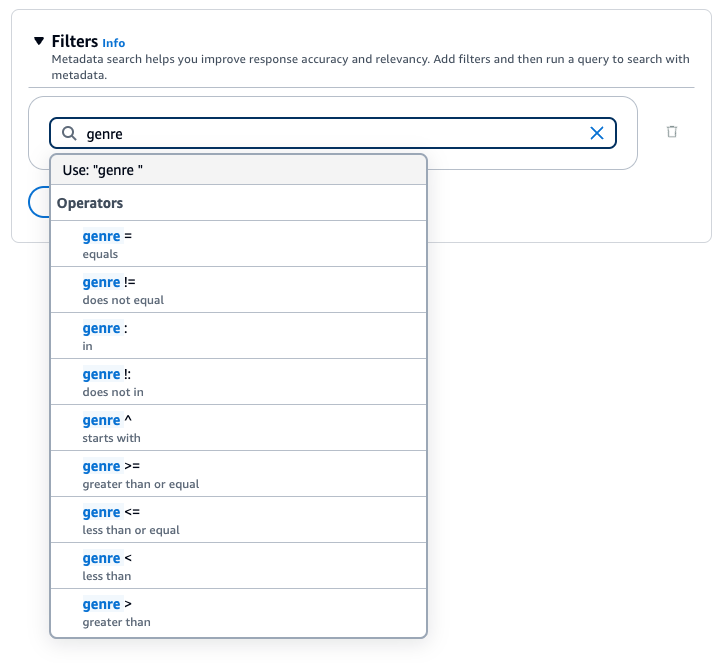
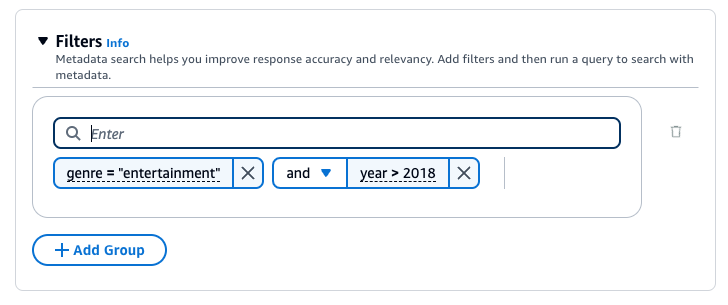
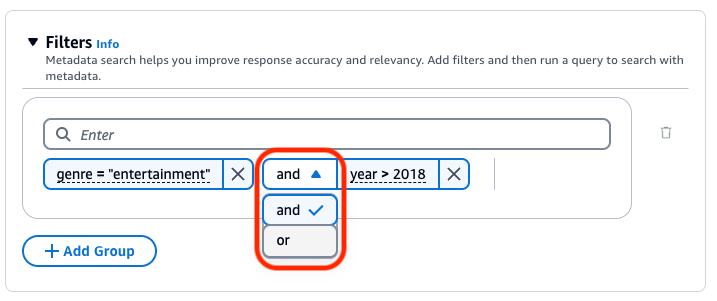
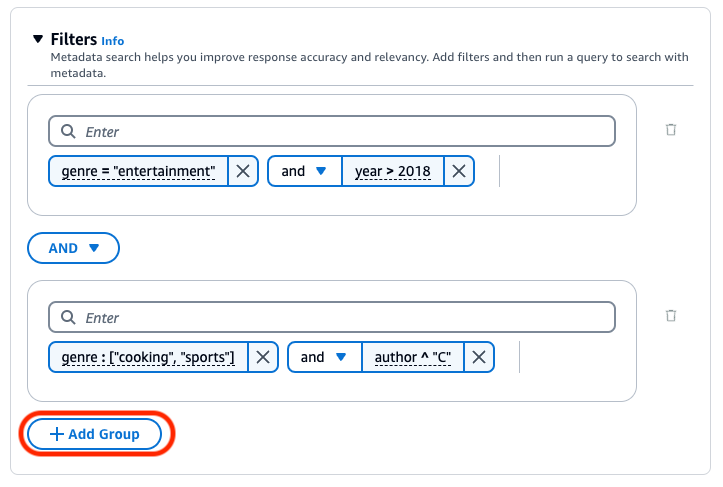
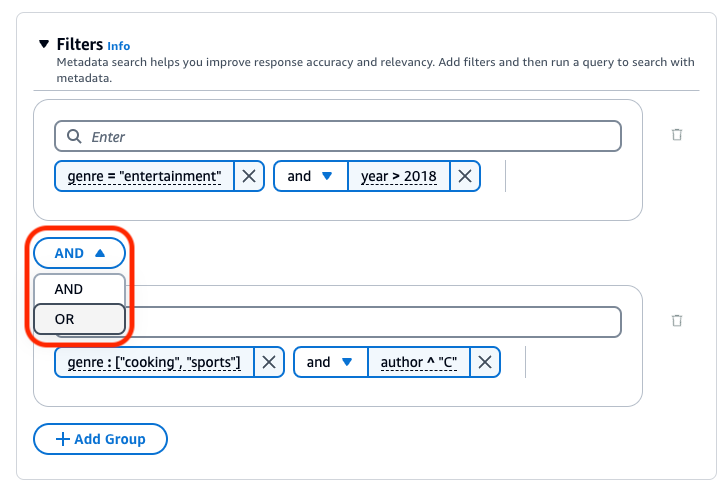
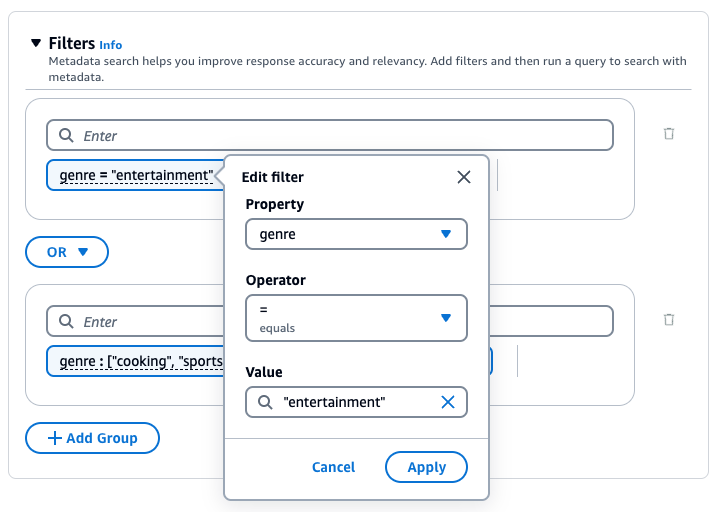
 )을 선택합니다. 필터를 제거하려면 필터 옆의 삭제 아이콘(
 )을 선택합니다.
사용 사례 및 책임 있는 AI 정책을 위한 지식 기반 보호 장치를 구현할 수 있습니다. 다양한 사용 사례에 맞게 조정된 여러 가드레일을 만들고 이를 여러 요청 및 응답 조건에 적용하여 일관된 사용자 환경을 제공하고 지식 기반 전반에 안전 제어를 표준화할 수 있습니다. 거부된 주제와 콘텐츠 필터를 구성하여 모델 입력 및 응답에서 바람직하지 않은 주제와 유해한 콘텐츠를 차단할 수 있습니다. 자세한 내용은 Amazon Bedrock Guardrails를 사용하여 유해한 콘텐츠 감지 및 필터링 섹션을 참조하세요.
참고
현재 Claude 3 Sonnet 및 Haiku에서는 가드레일을 지식 기반에 대한 컨텍스트 근거와 함께 사용할 수 없습니다.
일반적인 프롬프트 엔지니어링 지침은 프롬프트 엔지니어링 개념 섹션을 참조하세요.
원하는 방법의 탭을 선택한 후 다음 단계를 따릅니다.
리랭커 모델을 사용하여 지식 기반 쿼리의 결과 순위를 다시 매길 수 있습니다. 지식 기반 쿼리 및 데이터 검색 섹션의 콘솔 단계를 따릅니다. 구성 창을 열 때 순위 조정 섹션을 확장합니다. 리랭커 모델을 선택하고, 필요한 경우 권한을 업데이트하고, 추가 옵션을 수정합니다. 프롬프트를 입력하고 실행을 선택하여 순위를 다시 매긴 후 결과를 테스트합니다.
