View a markdown version of this page

为托管知识库配置和自定义查询 - Amazon Bedrock

本文属于机器翻译版本。若本译文内容与英语原文存在差异,则一律以英文原文为准。

为托管知识库配置和自定义查询

您可以配置和自定义检索,进一步提高结果的相关性。例如,您可以对文档元数据应用筛选器 fields/attributes ,以使用最近更新的文档或修改时间最近的文档。

注意

以下所有配置仅适用于非结构化数据源。

要详细了解控制台或 API 中的这些配置,请从以下主题中进行选择。

当您查询知识库时,默认情况下,Amazon Bedrock 会在响应中返回最多五个结果。每个结果都对应一个来源块。

注意

响应中的实际结果数可能小于指定的 numberOfResults 值,因为此参数设置了要返回的最大结果数。如果您为分块策略配置了分层分块,numberOfResults 参数会映射到知识库将检索的子分块的数量。由于共享同一父块的子块在最终响应中会被父块替换,因此返回的结果数可能少于请求的数量。

要修改返回的最大结果数,请选择与您的首选方法对应的选项卡,然后按照以下步骤操作:

Console

按照 查询知识库并检索数据 中的控制台步骤进行操作。在配置窗格中,展开来源分块部分,然后输入要返回的最大来源分块数。

API

当您提出RetrieveRetrieveAndGenerate请求时,请包括一个映射到KnowledgeBaseRetrievalConfiguration对象的retrievalConfiguration字段。要查看此字段的位置,请参阅 API 参考中的 RetrieveRetrieveAndGenerate 请求正文。

以下 JSON 对象显示了该KnowledgeBaseRetrievalConfiguration对象中设置要返回的最大结果数所需的最小字段:

"retrievalConfiguration": { "vectorSearchConfiguration": { "numberOfResults": number } }

指定要在numberOfResults字段中KnowledgeBaseRetrievalConfiguration返回的最大检索结果数(有关可接受值的范围,请参阅中的numberOfResults字段)。

您可以对文档应用筛选器 fields/attributes ,以帮助您进一步提高回复的相关性。您的数据源可以包含 attributes/fields 要筛选的文档元数据,并且可以指定嵌入中要包含哪些字段。

托管知识库注意事项

在托管知识库中使用元数据筛选时:

  • 不支持startsWithstringContains元数据过滤器。改用equalsgreaterThanlessThanin、或notIn运算符。

  • 范围运算符(greaterThangreaterThanOrEqualslessThan、、和lessThanOrEquals)接受数字或日期时间值。要按日期时间进行过滤,请将该值作为 ISO-8601 偏移日期时间格式的字符串提供。使用全偏移形式,例如2026-03-02T19:02:18Z。范围运算符仅支持托管知识库的日期时间字符串值。

  • 对于自定义知识库,前缀x-amz-bedrock为的元数据字段由服务保留。对于完全托管的知识库,保留的元数据字段使用下划线前缀(例如_source_uri,,_data_source_id)。您不能覆盖任一知识库类型中的保留元数据字段。

例如,“epoch_modification_time”表示文档自 1970 年 1 月 1 日(UTC)最后一次更新之后经历的秒数。您可以通过将“epoch_modification_time”设置为大于某个数值,筛选出最新的数据。这些最新的文档可用于查询。

要在查询知识库时使用筛选条件,请检查您的知识库是否满足以下要求:

  • 配置数据来源连接器时,大多数连接器都会抓取文档的主元数据字段。如果使用 Amazon S3 存储桶作为数据来源,则针对与其关联的文件或文档,该存储桶必须至少包含一个 fileName.extension.metadata.json。有关配置元数据文件的更多信息,请参阅连接配置中的文档元数据字段

  • 如果您的知识库的矢量索引在 Amazon OpenSearch Serverless 矢量存储中,请检查向量索引是否已使用faiss引擎配置。如果向量索引是使用 nmslib 引擎配置,则您必须执行以下操作之一:

  • 如果您的知识库使用 S3 向量存储桶中的向量索引,则无法使用 startsWithstringContains 筛选条件。

  • 如果您要向 Amazon Aurora 数据库集群中的现有向量索引添加元数据,建议您提供自定义元数据列的字段名称,以便将所有元数据存储在一个列中。在数据摄取期间,此列将用来填入数据来源中的元数据文件包含的所有信息。如果您选择提供该字段,则必须在此列上创建索引。

    • 当您在控制台中创建新的知识库,并让 Amazon Bedrock 配置您的 Amazon Aurora 数据库时,它将自动创建一个列,并用您的元数据文件中的信息填充该列。

    • 当您选择在向量存储中创建另一个向量索引时,必须提供自定义元数据字段名称,以存储元数据文件中的信息。如果未提供此字段名称,则必须为文件中的每个元数据属性创建一个列,并指定数据类型(文本、数字或布尔值)。例如,如果数据来源中存在属性 genre,您应添加名为 genre 的列,并指定 text 作为数据类型。在摄取期间,会在这些单独的列中填入相应的属性值。

如果您的数据源中有 PDF 文档,并且使用亚马逊 OpenSearch Serverless 或 Amazon Aurora 作为矢量存储:亚马逊 Bedrock 知识库将生成文档页码并将其存储在 field/attribute 名为 x-amz-bedrock-kb-document-page-number 的元数据中。请注意,如果您为文档选择不分块,则不支持在元数据字段中存储的页码。

您可以使用以下筛选运算符在查询时筛选结果:

筛选运算符
运算符 控制台 API 筛选条件名称 支持的属性数据类型 筛选结果
Equals = equals 字符串、数字、布尔值 属性与您提供的值相匹配
Not equals != noteQuals 字符串、数字、布尔值 属性与您提供的值不匹配
Greater than > greaterThan 数字 属性大于您提供的值
Greater than or equals >= 更大 ThanOrEquals 数字 属性大于或等于您提供的值
Less than < lessThan 数字 属性小于您提供的值
Less than or equals <= 更少 ThanOrEquals 数字 属性小于或等于您提供的值
In : in 字符串列表 属性在您提供的列表中(目前亚马逊 OpenSearch 无服务器和 Neptune Analytics GraphRag 矢量存储支持效果最佳)
Not in !: notIn 字符串列表 属性不在您提供的列表中(目前亚马逊 OpenSearch 无服务器和 Neptune Analytics GraphRag 矢量存储支持效果最佳)
String contains 不可用 stringContains 字符串 属性必须是字符串。属性名称与密钥相匹配,其值是一个字符串,其中包含您作为子字符串提供的值,或者一个包含您作为子字符串提供的值的成员列表(目前最适合由 Amazon OpenSearch Serverless 矢量存储支持)。海王星分析 GraphRag 矢量存储支持字符串变体,但不支持此过滤器的列表变体)。
List contains 不可用 listContains 字符串 属性必须采用字符串列表形式。属性名称与键相匹配,其值是一个列表,其中包含您作为其成员之一提供的值(目前 Amazon OpenSearch Serverless 矢量存储最支持该值)。

要组合筛选运算符,可以使用以下逻辑运算符:

逻辑运算符
运算符 控制台 API 筛选条件字段名称 筛选结果
And andAll 结果满足组中的所有筛选表达式
Or 或者 orAll 结果满足组中至少一个筛选表达式

要了解如何使用元数据筛选结果,请选择与您的首选方法对应的选项卡,然后按照以下步骤操作:
Console

按照 查询知识库并检索数据 中的控制台步骤进行操作。当你打开配置窗格时,你会看到筛选条件部分。以下过程介绍了不同的应用场景:

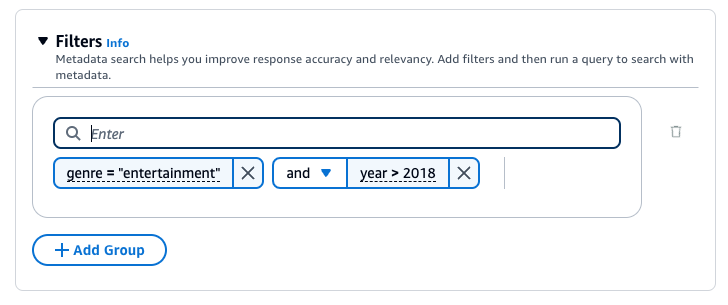
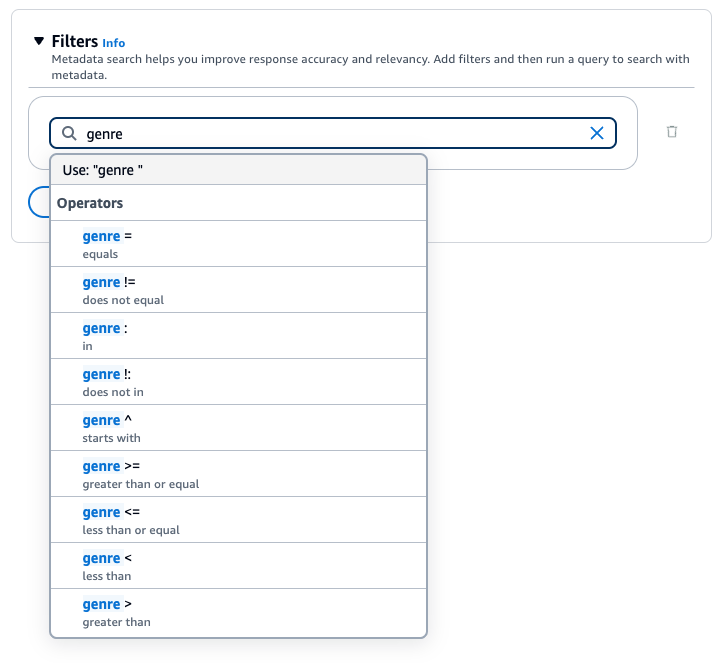
  • 要添加筛选条件,请在框中输入元数据属性、筛选运算符和值来创建筛选表达式。用空格分隔表达式的每个部分。按 Enter 来添加筛选条件。

    有关可接受的筛选运算符的列表,请参阅上面的筛选运算符表。在元数据属性后面添加空格时,您也可以看到筛选运算符列表。

    注意

    您必须用引号将字符串括起来。

    例如,您可以通过添加以下筛选条件从来源文档中筛选出包含值为 "entertainment"genre 元数据属性的结果:genre = "entertainment"

    添加一个筛选条件。
  • 要添加其他筛选条件,请在框中输入另一个筛选表达式,然后按 Enter。您最多可以在组中添加 5 个筛选条件。

    添加其他筛选条件。
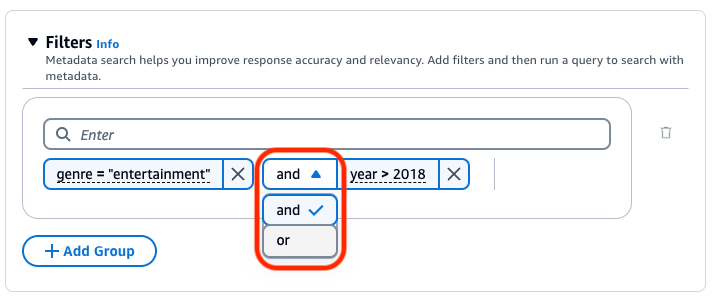
  • 默认情况下,查询将返回满足您提供的所有筛选表达式的结果。要返回至少满足其中一个筛选表达式的结果,请在任意两个筛选操作之间选择下拉菜单,然后选择

    更改筛选条件之间的逻辑操作。
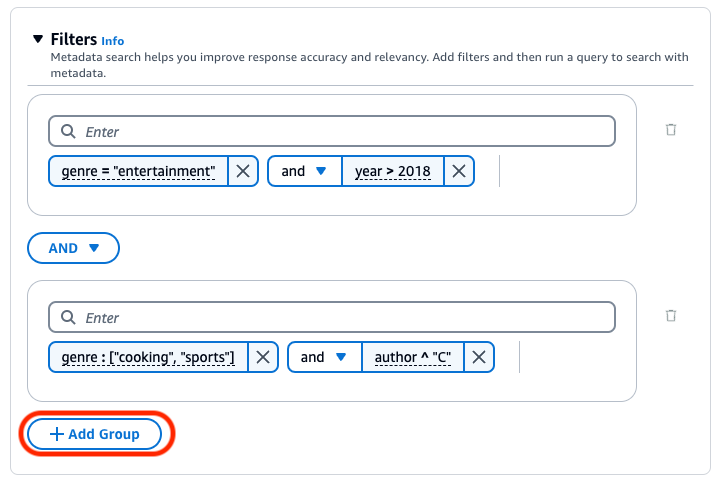
  • 要组合不同的逻辑运算符,请选择 + 添加组以添加筛选条件组。在新组中输入筛选表达式。您可以添加最多 5 个组。

    添加筛选条件组以组合不同的逻辑运算符。
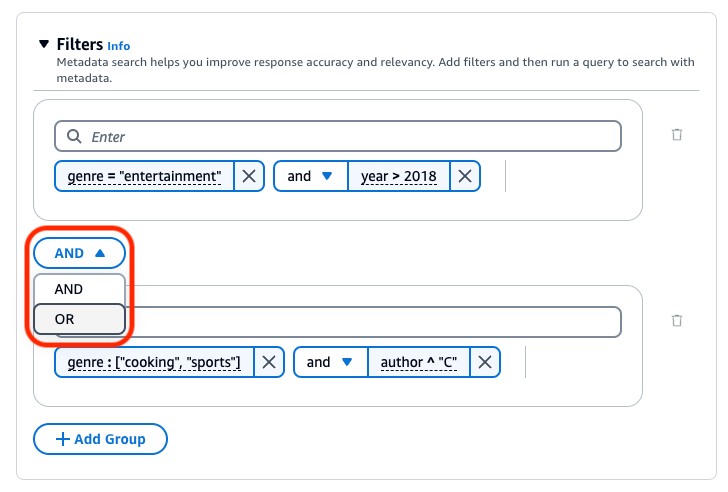
  • 要更改所有筛选组之间使用的逻辑运算符,请在任意两个筛选条件组之间选择 AND 下拉菜单,然后选择 OR

    更改筛选条件组之间的逻辑操作。
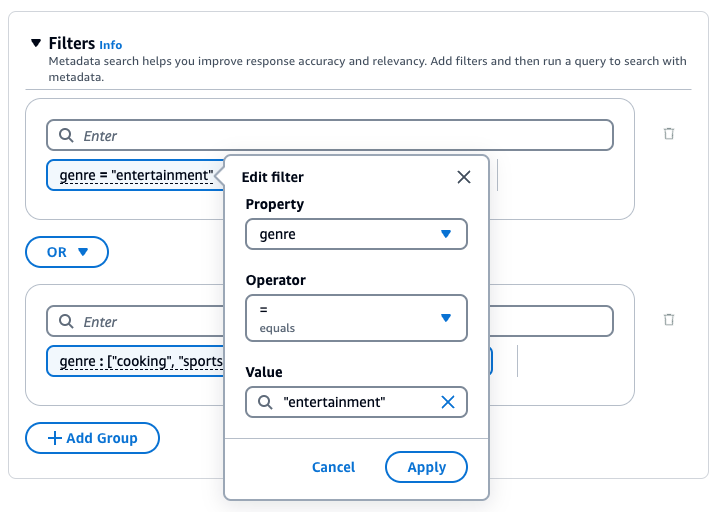
  • 要编辑筛选条件,请将其选中,修改筛选操作,然后选择应用

    编辑筛选条件。
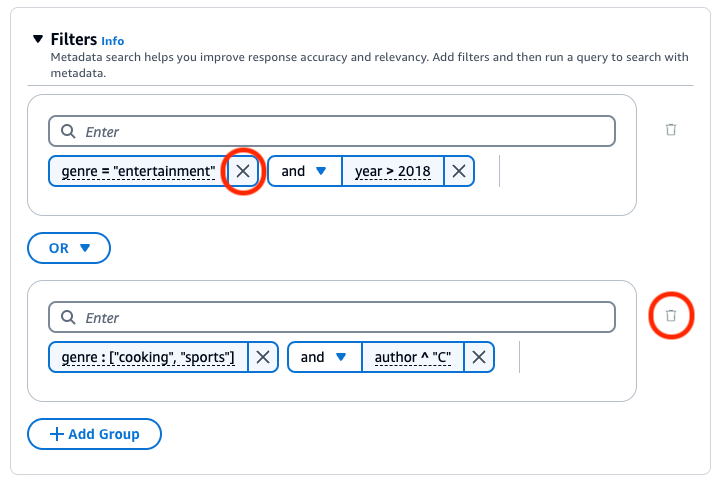
  • 要移除筛选条件组,请选择相应组旁边的垃圾桶图标 ( Trash can icon representing a delete action. )。要移除筛选条件,请选择相应筛选条件旁边的删除图标 ( Close or cancel icon represented by an "X" symbol. )。

    删除筛选条件或筛选条件组。

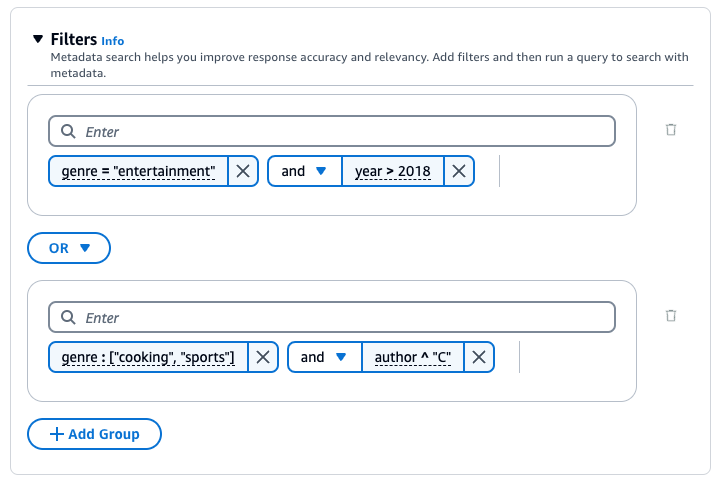
下图显示了一个筛选条件配置示例,除了类型为 "cooking""sports" 且作者名字以 "C" 开头的文档外,该配置还返回了所有 2018 之后编写的类型为 "entertainment" 的文档。

示例筛选条件配置。
API

当您提出RetrieveRetrieveAndGenerate请求时,请包括一个映射到KnowledgeBaseRetrievalConfiguration对象的retrievalConfiguration字段。要查看此字段的位置,请参阅 API 参考中的 RetrieveRetrieveAndGenerate 请求正文。

以下 JSON 对象显示了KnowledgeBaseRetrievalConfiguration对象中为不同用例设置过滤器所需的最小字段:

  1. 使用一个筛选运算符(请参阅上面的筛选运算符表)。

    "retrievalConfiguration": { "vectorSearchConfiguration": { "filter": { "<filter-type>": { "key": "string", "value": "string" | number | boolean | ["string", "string", ...] } } } }
  2. 使用逻辑运算符(请参阅上面的逻辑运算符表)最多可组合 5 个。

    "retrievalConfiguration": { "vectorSearchConfiguration": { "filter": { "andAll | orAll": [ "<filter-type>": { "key": "string", "value": "string" | number | boolean | ["string", "string", ...] }, "<filter-type>": { "key": "string", "value": "string" | number | boolean | ["string", "string", ...] }, ... ] } } }
  3. 使用逻辑运算符将最多 5 个筛选运算符组合到一个筛选条件组中,使用第二个逻辑运算符将该筛选条件组与其他筛选运算符组合。

    "retrievalConfiguration": { "vectorSearchConfiguration": { "filter": { "andAll | orAll": [ "andAll | orAll": [ "<filter-type>": { "key": "string", "value": "string" | number | boolean | ["string", "string", ...] }, "<filter-type>": { "key": "string", "value": "string" | number | boolean | ["string", "string", ...] }, ... ], "<filter-type>": { "key": "string", "value": "string" | number | boolean | ["string", "string", ...] } ] } } }
  4. 将最多 5 个筛选条件组嵌入到另一个逻辑运算符中,从而将它们组合。您可以创建一个嵌入级别。

    "retrievalConfiguration": { "vectorSearchConfiguration": { "filter": { "andAll | orAll": [ "andAll | orAll": [ "<filter-type>": { "key": "string", "value": "string" | number | boolean | ["string", "string", ...] }, "<filter-type>": { "key": "string", "value": "string" | number | boolean | ["string", "string", ...] }, ... ], "andAll | orAll": [ "<filter-type>": { "key": "string", "value": "string" | number | boolean | ["string", "string", ...] }, "<filter-type>": { "key": "string", "value": "string" | number | boolean | ["string", "string", ...] }, ... ] ] } } }

下表描述了您可以使用的筛选条件类型:

字段 支持的值数据类型 筛选结果
equals 字符串、数字、布尔值 属性与您提供的值相匹配
notEquals 字符串、数字、布尔值 属性与您提供的值不匹配
greaterThan 数字 属性大于您提供的值
greaterThanOrEquals 数字 属性大于或等于您提供的值
lessThan 数字 属性小于您提供的值
lessThanOrEquals 数字 属性小于或等于您提供的值
in 字符串列表 属性在您提供的列表中
notIn 字符串列表 属性不在您提供的列表中
startsWith 字符串 属性以您提供的字符串开头(仅支持亚马逊 OpenSearch 无服务器矢量存储)

要组合筛选条件类型,您可以使用以下逻辑运算符之一:

字段 映射到 筛选结果
andAll 最多 5 种筛选条件类型的列表 结果满足组中的所有筛选表达式
orAll 最多 5 种筛选条件类型的列表 结果满足组中至少一个筛选表达式

有关示例,请参阅发送查询并包含过滤器(检索)发送查询并包含过滤器(RetrieveAndGenerate)

您可以基于自己的应用场景和负责任的人工智能政策为知识库实施防护机制。您可以创建针对不同应用场景量身定制的多个防护机制,并跨多个请求和响应条件应用它们,从而在整个知识库中提供一致的用户体验并标准化安全控制。您可以将拒绝的主题配置为禁止不受欢迎的主题,将内容筛选条件配置为屏蔽模型输入和响应中的有害内容。有关更多信息,请参阅使用 Amazon Bedrock 护栏检测和筛选掉有害内容

注意

Claude 3 Sonnet 和 Haiku 目前不支持针对知识库应用具有上下文基础的防护机制。

有关提示工程的一般性准则,请参阅提示工程概念

选择与您的首选方法对应的选项卡,然后按照以下步骤操作:

Console

按照 查询知识库并检索数据 中的控制台步骤进行操作。在测试窗口中,打开生成响应。然后,在配置窗格中,展开防护机制部分。

  1. 防护机制部分,选择防护机制的名称版本。如果您想查看所选防护机制和版本的详细信息,请选择查看

    或者,您可以通过选择防护机制链接来创建一个新的机制。

  2. 编辑完成后,选择保存更改。要退出而不保存更改,请选择放弃更改

API

在提出 RetrieveAndGenerate 请求时,请在 generationConfiguration 中添加 guardrailConfiguration 字段,以将防护机制用于该请求。要查看此字段的位置,请参阅 API 参考中的 RetrieveAndGenerate 请求正文。

以下 JSON 对象显示了在中设置所需的最小字段guardrailConfigurationGenerationConfiguration

"generationConfiguration": { "guardrailConfiguration": { "guardrailId": "string", "guardrailVersion": "string" } }

指定所选防护机制的 guardrailVersionguardrailId

您可以使用重排器模型对知识库查询的结果进行重排。按照 查询知识库并检索数据 中的控制台步骤进行操作。打开配置窗格后,展开重排部分。选择重排模型,必要时更新权限,并修改任何其他选项。完成重排后,输入提示,然后选择运行以测试结果。