AWS Systems Manager Incident Manager n'est plus ouvert aux nouveaux clients. Les clients existants peuvent continuer à utiliser le service normalement. Pour plus d'informations, consultez AWS Systems Manager Incident Manager la section Modification de disponibilité.
Les traductions sont fournies par des outils de traduction automatique. En cas de conflit entre le contenu d'une traduction et celui de la version originale en anglais, la version anglaise prévaudra.
Préparation aux incidents dans Incident Manager
La planification d'un incident commence bien avant le cycle de vie de l'incident. Comme le montre l'illustration suivante, avant de commencer à répondre aux incidents, vous devez vous préparer en configurant des canaux de discussion, en créant des plans d'escalade, en spécifiant les contacts et en déterminant les runbooks d'automatisation à utiliser pour répondre aux incidents. Utilisez ensuite un plan de réponse qui précise comment la surveillance s'effectue et si les réponses sont automatisées. Une fois les mesures correctives terminées, vous pouvez analyser l'incident et la réponse aux incidents afin d'affiner votre plan de réponse en cas d'incidents futurs.
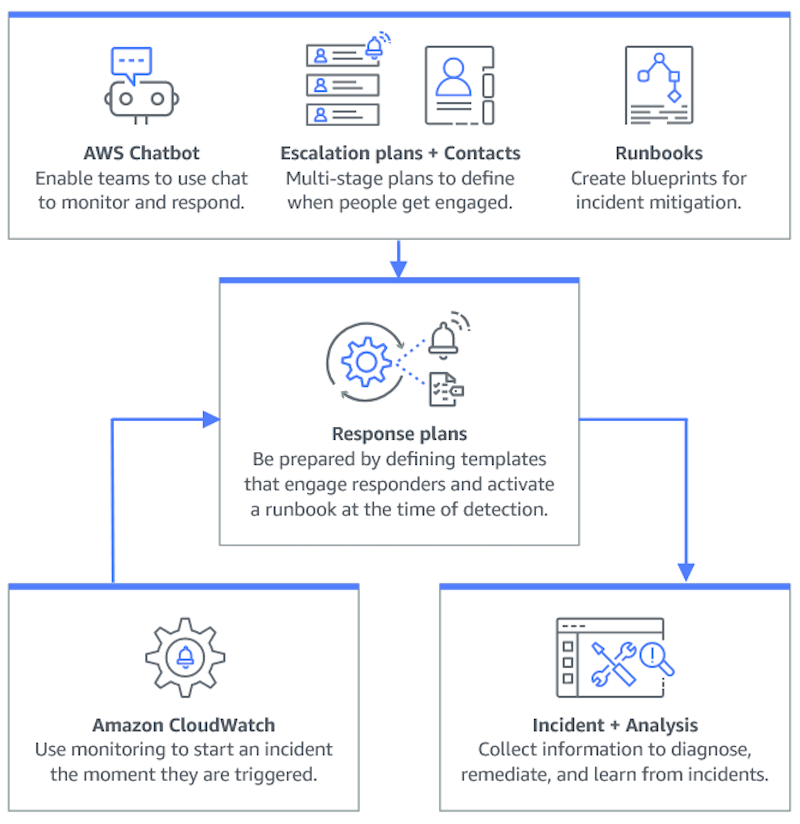
Rubriques
Configuration des ensembles de réplication et des résultats dans Incident Manager
Gestion de la rotation des intervenants à l'aide de calendriers d'astreinte dans Incident Manager
Création d'un plan d'escalade pour l'engagement des intervenants dans Incident Manager
Création et intégration de canaux de discussion pour les intervenants dans Incident Manager
Création et configuration de plans de réponse dans Incident Manager
Contrôle
La surveillance de l'état de santé de vos applications AWS hébergées est essentielle pour garantir la disponibilité et les performances des applications. Lorsque vous déterminez des solutions de surveillance, tenez compte des points suivants :
-
Criticité de la fonctionnalité : si le système venait à tomber en panne, quelle serait l'importance de l'impact sur les utilisateurs en aval ?
-
Caractéristiques communes des défaillances — Quelle est la fréquence des défaillances d'un système ? Les systèmes qui nécessitent une intervention fréquente doivent être surveillés de près.
-
Latence accrue : le temps nécessaire à l'exécution d'une tâche a augmenté ou diminué.
-
Client-side par rapport aux métriques côté serveur : s'il existe un écart entre les métriques associées sur le client et le serveur.
-
Défaillances liées à la dépendance : échecs auxquels votre équipe peut et doit se préparer.
Après avoir créé des plans d'intervention, vous pouvez utiliser vos solutions de surveillance pour suivre automatiquement les incidents dès qu'ils se produisent dans votre environnement. Pour plus d'informations sur le suivi et la création d'incidents, consultezAfficher les détails de l'incident dans la console Incident Manager.
Pour plus d'informations sur l'architecture d'applications et de charges de travail d'infrastructure sécurisées, performantes, résilientes et efficaces, consultez le. AWS Well-Architected
