Amazon Redshift tidak akan lagi mendukung penggunaan Python UDF setelah 30 Juni 2026. Kami akan mulai menegakkannya secara bertahap. Untuk informasi lebih lanjut tentang detail opsi akhir masa pakai dan migrasi Python, lihat posting blog
Terjemahan disediakan oleh mesin penerjemah. Jika konten terjemahan yang diberikan bertentangan dengan versi bahasa Inggris aslinya, utamakan versi bahasa Inggris.
Memulai dengan gudang data yang disediakan Amazon Redshift
Jika Anda adalah pengguna Amazon Redshift pertama kali, kami sarankan Anda membaca bagian berikut untuk membantu Anda mulai menggunakan cluster yang disediakan. Alur dasar Amazon Redshift adalah membuat sumber daya yang disediakan, terhubung ke Amazon Redshift, memuat data sampel, dan kemudian menjalankan kueri pada data. Dalam panduan ini, Anda dapat memilih untuk memuat data sampel dari Amazon Redshift atau dari bucket Amazon S3. Data sampel digunakan di seluruh dokumentasi Amazon Redshift untuk mendemonstrasikan fitur.
Tutorial ini menunjukkan cara menggunakan cluster yang disediakan Amazon Redshift, yang merupakan objek gudang AWS data tempat Anda mengelola sumber daya sistem. Anda juga dapat menggunakan Amazon Redshift dengan grup kerja tanpa server, yang merupakan objek gudang data yang berskala secara otomatis sebagai respons terhadap penggunaan. Untuk memulai menggunakan Redshift Serverless, lihat. Memulai dengan gudang data tanpa server Amazon Redshift
Setelah membuat dan masuk ke konsol Amazon Redshift yang disediakan, Anda dapat membuat dan mengelola objek Amazon Redshift, termasuk cluster, node, dan database. Anda juga dapat menjalankan kueri, melihat kueri, dan melakukan operasi bahasa definisi data SQL (DDL) dan bahasa manipulasi data (DML) lainnya dengan klien SQL.
penting
Cluster yang Anda sediakan untuk latihan ini berjalan di lingkungan hidup. Selama berjalan, itu menimbulkan biaya kepada Anda Akun AWS. Untuk informasi harga, lihat halaman harga
Untuk menghindari biaya yang tidak perlu, hapus cluster Anda setelah selesai menggunakannya. Bagian terakhir dari pasal ini menjelaskan bagaimana melakukannya.
Masuk ke Konsol Manajemen AWS dan buka konsol Amazon Redshift di https://console.aws.amazon.com/redshiftv2/
Kami menyarankan Anda memulai dengan membuka dasbor cluster yang disediakan untuk memulai menggunakan konsol Amazon Redshift.
Bergantung pada konfigurasi Anda, item berikut muncul di panel navigasi konsol Amazon Redshift yang disediakan:
Redshift Serverless — Akses dan analisis data tanpa perlu menyiapkan, menyetel, dan mengelola cluster yang disediakan Amazon Redshift.
Dasbor cluster yang disediakan — Lihat daftar cluster di klaster Anda Wilayah AWS, periksa metrik Cluster dan ikhtis ar Kueri untuk wawasan data metrik (seperti pemanfaatan CPU) dan informasi kueri. Informasi ini dapat membantu Anda menentukan apakah data performa Anda tidak normal pada rentang waktu yang ditentukan.
Cluster — Lihat daftar cluster Anda di sini Wilayah AWS, pilih cluster untuk mulai menanyakan, atau lakukan tindakan terkait cluster. Anda juga dapat membuat cluster baru dari halaman ini.
Editor kueri — Jalankan kueri pada database yang dihosting di cluster Amazon Redshift Anda. Sebaiknya gunakan editor Query v2 sebagai gantinya.
Editor kueri v2 — Editor kueri Amazon Redshift v2 adalah aplikasi klien SQL berbasis web terpisah untuk membuat dan menjalankan kueri di gudang data Amazon Redshift Anda. Anda dapat memvisualisasikan hasil Anda dalam bagan dan berkolaborasi dengan membagikan kueri Anda dengan orang lain di tim Anda.
Kueri dan beban — Dapatkan informasi untuk referensi atau pemecahan masalah, seperti daftar kueri terbaru dan teks SQL untuk setiap kueri.
Datashares — Sebagai administrator akun produsen, otorisasi akun konsumen untuk mengakses data share atau memilih untuk tidak mengotorisasi akses. Untuk menggunakan datashare resmi, administrator akun konsumen dapat mengaitkan datashare dengan seluruh Akun AWS atau ruang nama cluster tertentu dalam akun. Administrator juga dapat menolak datashare.
Zero-ETL integrasi — Kelola integrasi yang membuat data transaksional tersedia di Amazon Redshift setelah ditulis dalam sumber yang didukung.
Koneksi Pusat Identitas IAM — Konfigurasikan koneksi antara Amazon Redshift dan Pusat Identitas IAM.
Konfigurasi — Sambungkan ke cluster Amazon Redshift dari alat klien SQL melalui koneksi Java Database Connectivity (JDBC) dan Open Database Connectivity (ODBC). Anda juga dapat mengatur titik akhir cloud pribadi virtual (VPC) yang dikelola Amazon Redshift. Melakukannya menyediakan koneksi pribadi antara VPC berdasarkan layanan Amazon VPC yang berisi cluster dan VPC lain yang menjalankan alat klien.
AWS Integrasi Mitra — Buat integrasi dengan Mitra yang didukung AWS .
Penasihat — Dapatkan rekomendasi spesifik tentang perubahan yang dapat Anda buat pada cluster Amazon Redshift Anda untuk memprioritaskan pengoptimalan Anda.
AWS Marketplace — Dapatkan informasi tentang alat atau AWS layanan lain yang bekerja dengan Amazon Redshift.
Alarm — Buat alarm pada metrik cluster untuk melihat data kinerja dan melacak metrik selama periode waktu yang Anda tentukan.
A cara — Lacak peristiwa dan dapatkan laporan tentang informasi seperti tanggal peristiwa terjadi, deskripsi, atau sumber peristiwa.
Apa yang baru — Lihat fitur Amazon Redshift baru dan pembaruan produk.
Dalam tutorial ini, Anda melakukan langkah-langkah berikut.
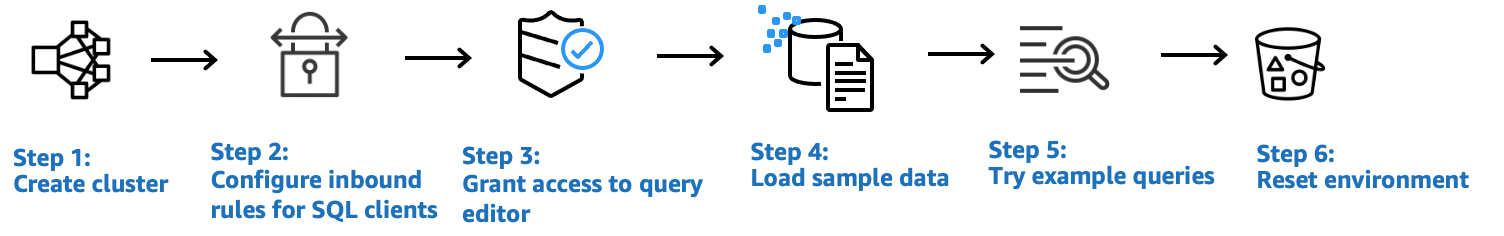
Topik
Mendaftar untuk Akun AWS
Untuk memulainya AWS, Anda membutuhkan Akun AWS. Untuk informasi tentang membuat Akun AWS, lihat Mem ulai dengan an Akun AWS di Panduan AWS Account Management Referensi.
Tentukan aturan firewall
catatan
Tutorial ini mengasumsikan cluster Anda menggunakan port default 5439 dan editor kueri Amazon Redshift v2 dapat digunakan untuk menjalankan perintah SQL. Itu tidak masuk ke detail tentang konfigurasi jaringan atau menyiapkan klien SQL yang mungkin diperlukan di lingkungan Anda.
Di beberapa lingkungan, Anda menentukan port saat meluncurkan cluster Amazon Redshift Anda. Anda menggunakan port ini bersama dengan URL endpoint cluster untuk mengakses cluster. Anda juga membuat aturan masuk masuk dalam grup keamanan untuk mengizinkan akses melalui port ke cluster Anda.
Jika komputer klien Anda berada di belakang firewall, pastikan Anda tahu port terbuka yang dapat Anda gunakan. Dengan menggunakan port terbuka ini, Anda dapat terhubung ke cluster dari alat klien SQL dan menjalankan kueri. Jika Anda tidak mengetahui port terbuka, bekerjalah dengan seseorang yang memahami aturan firewall jaringan Anda untuk menentukan port terbuka di firewall Anda.
Meskipun Amazon Redshift menggunakan port 5439 secara default, koneksi tidak berfungsi jika port itu tidak terbuka di firewall Anda. Anda tidak dapat mengubah nomor port untuk cluster Amazon Redshift setelah dibuat. Jadi, pastikan Anda menentukan port terbuka yang berfungsi di lingkungan Anda selama proses peluncuran.
Langkah 1: Buat contoh cluster Amazon Redshift
Dalam tutorial ini, Anda berjalan melalui proses untuk membuat cluster Amazon Redshift dengan database. Kemudian Anda memuat dataset dari Amazon S3 ke tabel di database Anda. Anda dapat menggunakan cluster sampel ini untuk mengevaluasi layanan Amazon Redshift.
Sebelum Anda mulai menyiapkan cluster Amazon Redshift, pastikan Anda menyelesaikan prasyarat yang diperlukan sepertiTentukan aturan firewall.
Untuk operasi apa pun yang mengakses data dari AWS sumber daya lain, cluster Anda memerlukan izin untuk mengakses sumber daya dan data pada sumber daya atas nama Anda. Contohnya adalah menggunakan perintah SQL COPY untuk memuat data dari Amazon Simple Storage Service (Amazon S3). Anda memberikan izin tersebut dengan menggunakan AWS Identity and Access Management (IAM). Anda dapat melakukan ini melalui peran IAM yang Anda buat dan lampirkan ke cluster Anda. Untuk informasi selengkapnya tentang kredenSIAL dan izin akses, lihat KredenSIAL dan izin akses di Panduan Pengembang Database Amazon Redshift.
Cara membuat cluster Amazon Redshift
-
Masuk ke Konsol Manajemen AWS dan buka konsol Amazon Redshift di https://console.aws.amazon.com/redshiftv2/
. penting
Jika Anda menggunakan kredentif pengguna IAM, pastikan Anda memiliki izin yang diperlukan untuk melakukan operasi cluster. Untuk informasi selengkapnya, lihat Keamanan di Amazon Redshift di Panduan Manajemen Amazon Redshift.
-
Di AWS konsol, pilih Wilayah AWS tempat Anda ingin membuat cluster.
-
Pada menu navigasi, pilih Cluster, lalu pilih Buat cluster. Halaman Buat cluster muncul.
-
Di bagian Konfigur asi Cluster, tentukan nilai untuk Pengi dentifikasi Cluster, Jenis Node, dan Node:
-
Pengidentifikasi cluster: Masukkan
exampleclusteruntuk tutorial ini. Pengidentifikasi ini harus unik. Pengidentifikasi harus dari 1-63 karakter menggunakan karakter yang valid a—z (hanya huruf kecil) dan - (tanda hubung). -
Pilih salah satu metode berikut untuk mengukur cluster Anda:
catatan
Langkah berikut mengasumsikan Wilayah AWS yang mendukung tipe node RG. Untuk daftar jenis node RG atau RA3 Wilayah AWS yang mendukung, lihat Ketersediaan tipe node RG di Wil AWS ayah dan ketersediaan tipe node RA3 di Wil AWS ayah di Panduan Manajemen Amazon Redshift. Untuk mempelajari selengkapnya tentang spesifikasi node untuk setiap jenis dan ukuran simpul, lihat Detail jenis Node.
-
Jika Anda tidak tahu seberapa besar ukuran cluster Anda, pilih B antu saya memilih. Melakukannya membuka kalkulator ukuran yang menanyakan pertanyaan tentang ukuran dan karakteristik kueri dari data yang Anda rencanakan untuk disimpan di gudang data Anda.
Jika Anda mengetahui ukuran cluster yang diperlukan (yaitu, jenis node dan jumlah node), pilih Saya akan memilih. Kemudian pilih jenis Node dan jumlah Node untuk mengukur cluster Anda.
Untuk tutorial ini, pilih rg.4xlarge untuk tipe Node dan 2 untuk Jumlah node.
Jika pilihan untuk konfigurasi AZ tersedia, pilih Single-AZ.
Untuk menggunakan kumpulan data sampel yang disediakan Amazon Redshift, di Data sampel, pilih Muat data sampel. Amazon Redshift memuat kumpulan data sampel Tickit ke
devdatabase danpublicskema default.
-
-
-
Di bagian konfigurasi database, tentukan nilai untuk nama pengguna Admin. Untuk kata sandi Admin, pilih dari opsi berikut:
-
Buat kata sandi — Gunakan kata sandi yang dihasilkan oleh Amazon Redshift.
-
Tambahkan kata sandi admin secara manual — Gunakan kata sandi Anda sendiri.
-
Kelola kredensi admin di AWS Secrets Manager - Amazon Redshift digunakan AWS Secrets Manager untuk membuat dan mengelola kata sandi admin Anda. Menggunakan AWS Secrets Manager untuk menghasilkan dan mengelola rahasia kata sandi Anda dikenakan biaya. Untuk informasi tentang AWS Secrets Manager harga, lihat AWS Secrets Manager Harga
.
Untuk tutorial ini, gunakan nilai-nilai ini:
Nama pengguna admin: Masukkan
awsuser.Kata sandi pengguna admin:
Changeit1Masukkan kata sandi.
-
-
Untuk tutorial ini, buat peran IAM dan tetapkan sebagai default untuk cluster Anda, seperti yang dijelaskan berikut. Hanya dapat ada satu peran IAM default yang ditetapkan untuk cluster.
Di bawah Izin klaster, untuk Kelola peran IAM, pilih Buat peran IAM.
Tentukan bucket Amazon S3 untuk peran IAM untuk diakses dengan salah satu metode berikut:
Pilih Tidak ada bucket Amazon S3 tambahan untuk mengizinkan peran IAM yang dibuat hanya mengakses bucket Amazon S3 yang diberi nama sebagai
redshift.Pilih Bucket Amazon S3 apa saja untuk mengizinkan peran IAM yang dibuat mengakses semua bucket Amazon S3.
Pilih Bucket Amazon S3 Khus us untuk menentukan satu atau beberapa bucket Amazon S3 untuk peran IAM yang dibuat untuk diakses. Kemudian pilih satu atau lebih bucket Amazon S3 dari tabel.
Pilih Buat peran IAM sebagai default. Amazon Redshift secara otomatis membuat dan menetapkan peran IAM sebagai default untuk cluster Anda.
Karena Anda membuat peran IAM dari konsol, itu memiliki
AmazonRedshiftAllCommandsFullAccesskebijakan yang dilampirkan. Ini memungkinkan Amazon Redshift untuk menyalin, memuat, menanyakan, dan menganalisis data dari sumber daya Amazon di akun IAM Anda.
Untuk informasi tentang cara mengelola peran IAM default untuk cluster, lihat Membuat peran IAM sebagai default untuk Amazon Redshift di Panduan Manajemen Amazon Redshift.
-
(Opsional) Di bagian Konfigurasi tambahan, matikan Gunakan default untuk mengubah pengaturan Jaringan dan keamanan, Konfigurasi database, Pem eliharaan, Pem antauan , dan Cadangan.
Dalam beberapa kasus, Anda dapat membuat cluster dengan opsi Muat data sampel dan ingin mengaktifkan perutean Amazon VPC yang disempurnakan. Jika demikian, cluster di cloud pribadi virtual (VPC) memerlukan akses ke titik akhir Amazon S3 agar data dapat dimuat.
Untuk membuat cluster dapat diakses publik, Anda dapat melakukan salah satu dari dua hal. Anda dapat mengonfigurasi alamat terjemahan alamat jaringan (NAT) di VPC Anda agar cluster dapat mengakses internet. Atau Anda dapat mengonfigurasi titik akhir Amazon S3 VPC di VPC Anda. Untuk informasi selengkapnya tentang perutean Amazon VPC yang disempurnakan, lihat Per utean VPC Amazon yang Diting katkan di Panduan Manajemen Amazon Redshift.
-
Pilih Buat klaster. Tunggu cluster Anda dibuat dengan
Availablestatus di halaman Cluster.
Langkah 2: Konfigurasikan aturan masuk untuk klien SQL
catatan
Kami sarankan Anda melewatkan langkah ini dan mengakses cluster Anda menggunakan editor kueri Amazon Redshift v2.
Kemudian dalam tutorial ini, Anda mengakses cluster Anda dari dalam cloud pribadi virtual (VPC) berdasarkan layanan Amazon VPC. Namun, jika Anda menggunakan klien SQL dari luar firewall Anda untuk mengakses cluster, pastikan Anda memberikan akses masuk.
Untuk memeriksa firewall Anda dan memberikan akses masuk ke cluster Anda
Periksa aturan firewall Anda jika cluster Anda perlu diakses dari luar firewall. Misalnya, klien Anda mungkin instans Amazon Elastic Compute Cloud (Amazon EC2) atau komputer eksternal.
Untuk informasi selengkapnya tentang aturan firewall, lihat Aturan grup keamanan di Panduan Pengguna Amazon EC2.
Untuk mengakses dari klien eksternal Amazon EC2, tambahkan aturan masuk ke grup keamanan yang dilampirkan ke cluster Anda yang memungkinkan lalu lintas masuk. Anda menambahkan aturan grup keamanan Amazon EC2 di konsol Amazon EC2. Misalnya, a CIDR/IP dari 192.0.2. 0/24 memungkinkan klien dalam rentang alamat IP tersebut untuk terhubung ke cluster Anda. Cari tahu yang benar CIDR/IP untuk lingkungan Anda.
Langkah 3: Berikan akses ke klien SQL dan jalankan kueri
Untuk menanyakan database yang dihosting oleh cluster Amazon Redshift Anda, Anda memiliki beberapa opsi untuk klien SQL. Ini termasuk:
Hubungkan ke cluster Anda dan jalankan kueri menggunakan editor kueri Amazon Redshift v2.
Jika Anda menggunakan query editor v2, Anda tidak perlu mengunduh dan menyiapkan aplikasi klien SQL. Anda meluncurkan editor kueri Amazon Redshift v2 dari konsol Amazon Redshift.
Hubungkan ke cluster Anda menggunakan RSQL. Untuk informasi selengkapnya, lihat Menghubungkan dengan Amazon Redshift RSQL di Panduan Manajemen Amazon Redshift.
-
Hubungkan ke cluster Anda melalui alat klien SQL, seperti SQL Workbench/J. Untuk informasi selengkapnya, lihat Menghubun gkan ke cluster Anda menggunakan SQL Workbench/J di Panduan Manajemen Amazon Redshift.
Tutorial ini menggunakan editor kueri Amazon Redshift v2 sebagai cara mudah untuk menjalankan kueri pada database yang dihosting oleh cluster Amazon Redshift Anda. Setelah membuat cluster Anda, Anda dapat segera menjalankan query. Untuk detail tentang pertimbangan saat menggunakan editor kueri Amazon Redshift v2, lihat Per timbangan saat bekerja dengan editor kueri v2 di Panduan Manajemen Amazon Redshift.
Memberikan akses ke editor kueri v2
Pertama kali administrator mengonfigurasi editor kueri v2 untuk Anda Akun AWS, mereka memilih AWS KMS key yang digunakan untuk mengenkripsi sumber daya editor kueri v2. Sumber daya Amazon Redshift query editor v2 mencakup kueri, buku catatan, dan bagan yang disimpan. Secara default, kunci yang AWS dimiliki digunakan untuk mengenkripsi sumber daya. Sebagai alternatif, administrator dapat menggunakan kunci yang dikelola pelanggan dengan memilih Amazon Resource Name (ARN) untuk kunci di halaman konfigurasi. Setelah Anda mengonfigurasi akun, pengaturan AWS KMS enkripsi tidak dapat diubah. Untuk informasi selengkapnya, lihat Mengonfigurasi Anda Akun AWS di Panduan Manajemen Amazon Redshift.
Untuk mengakses editor kueri v2, Anda memerlukan izin. Administrator dapat melampirkan salah satu kebijakan AWS terkelola untuk editor kueri Amazon Redshift v2 ke peran atau pengguna IAM untuk memberikan izin. Kebijakan AWS terkelola ini ditulis dengan opsi berbeda yang mengontrol bagaimana penandaan sumber daya memungkinkan berbagi kueri. Anda dapat menggunakan konsol IAM (https://console.aws.amazon.com/iam/
Anda juga dapat membuat kebijakan sendiri berdasarkan izin yang diizinkan dan ditolak dalam kebijakan terkelola yang disediakan. Jika Anda menggunakan editor kebijakan konsol IAM untuk membuat kebijakan Anda sendiri, pilih SQL Workbench sebagai layanan yang Anda buat kebijakan di editor visual. Editor kueri v2 menggunakan nama layanan AWS SQL Workbench di editor visual dan IAM Policy Simulator.
Untuk informasi selengkapnya, lihat Bekerja dengan editor kueri v2 di Panduan Manajemen Amazon Redshift.
Langkah 4: Muat data dari Amazon S3 ke Amazon Redshift
Setelah membuat cluster, Anda dapat memuat data dari Amazon S3 ke tabel database Anda. Ada beberapa cara untuk memuat data dari Amazon S3.
Anda dapat menggunakan klien SQL untuk menjalankan perintah SQL CREATE TABLE untuk membuat tabel di database Anda dan kemudian menggunakan perintah SQL COPY untuk memuat data dari Amazon S3. Editor kueri Amazon Redshift v2 adalah klien SQL.
Anda dapat menggunakan wizard pemuatan editor kueri Amazon Redshift v2.
Tutorial ini menunjukkan cara menggunakan editor kueri Amazon Redshift v2 untuk menjalankan perintah SQL untuk MEMBUAT tabel dan menyalin data. Luncur kan Query editor v2 dari panel navigasi konsol Amazon Redshift. Dalam query editor v2 buat koneksi ke examplecluster cluster dan database bernama dev dengan pengguna admin Andaawsuser. Untuk tutorial ini pilih KredenSIAL sementara menggunakan nama pengguna database saat Anda membuat koneksi. Untuk detail tentang penggunaan editor kueri Amazon Redshift v2, lihat Mengh ubungkan ke database Amazon Redshift di Panduan Manajemen Amazon Redshift.
Memuat data dari Amazon S3 menggunakan perintah SQL
Pada panel editor kueri editor kueri v2, konfirmasikan bahwa Anda terhubung ke examplecluster cluster dan dev database. Selanjutnya, buat tabel dalam database dan muat data ke tabel. Untuk tutorial ini, data yang Anda muat tersedia dalam bucket Amazon S3 yang dapat diakses dari banyak orang Wilayah AWS.
Prosedur berikut membuat tabel dan memuat data dari bucket Amazon S3 publik.
Gunakan editor kueri Amazon Redshift v2 untuk menyalin dan menjalankan pernyataan create table berikut untuk membuat tabel dalam public skema dev database. Untuk informasi selengkapnya tentang sintaks, lihat MEMBUAT TABEL di Panduan Pengembang Database Amazon Redshift.
Untuk membuat dan memuat data menggunakan klien SQL seperti query editor v2
-
Jalankan perintah SQL berikut untuk MEMBUAT
salestabel.drop table if exists sales;create table sales( salesid integer not null, listid integer not null distkey, sellerid integer not null, buyerid integer not null, eventid integer not null, dateid smallint not null sortkey, qtysold smallint not null, pricepaid decimal(8,2), commission decimal(8,2), saletime timestamp); -
Jalankan perintah SQL berikut untuk MEMBUAT
datetabel.drop table if exists date;create table date( dateid smallint not null distkey sortkey, caldate date not null, day character(3) not null, week smallint not null, month character(5) not null, qtr character(5) not null, year smallint not null, holiday boolean default('N')); -
Muat
salestabel dari Amazon S3 menggunakan perintah COPY.catatan
Sebaiknya gunakan perintah COPY untuk memuat kumpulan data besar ke Amazon Redshift dari Amazon S3. Untuk informasi selengkapnya tentang sintaks COPY, lihat COP Y di Panduan Pengembang Database Amazon Redshift.
Berikan otentikasi untuk cluster Anda untuk mengakses Amazon S3 atas nama Anda untuk memuat data sampel. Anda memberikan otentikasi dengan mereferensikan peran IAM yang Anda buat dan tetapkan sebagai
defaultuntuk cluster Anda ketika Anda memilih Buat peran IAM sebagai default saat Anda membuat cluster.Muat
salestabel menggunakan perintah SQL berikut. Anda dapat secara opsional mengunduh dan melihat dari Amazon S3 data sumber untuksalestabel. . COPY sales FROM 's3://redshift-downloads/tickit/sales_tab.txt' DELIMITER '\t' TIMEFORMAT 'MM/DD/YYYY HH:MI:SS' REGION 'us-east-1' IAM_ROLE default; -
Muat
datetabel menggunakan perintah SQL berikut. Anda dapat secara opsional mengunduh dan melihat dari Amazon S3 data sumber untukdatetabel. . COPY date FROM 's3://redshift-downloads/tickit/date2008_pipe.txt' DELIMITER '|' REGION 'us-east-1' IAM_ROLE default;
Memuat data dari Amazon S3 menggunakan editor kueri v2
Bagian ini menjelaskan memuat data Anda sendiri ke dalam cluster Amazon Redshift. Editor kueri v2 menyederhanakan pemuatan data saat menggunakan wizard Load data. Perintah COPY yang dihasilkan dan digunakan dalam editor kueri v2 Load data wizard mendukung banyak parameter yang tersedia untuk sintaks perintah COPY untuk memuat data dari Amazon S3. Untuk informasi tentang perintah COPY dan opsinya yang digunakan untuk menyalin beban dari Amazon S3, lihat SALIN dari Amazon Simple Storage Service di Panduan Pengembang Database Amazon Redshift.
Untuk memuat data Anda sendiri dari Amazon S3 ke Amazon Redshift, Amazon Redshift memerlukan peran IAM yang memiliki hak istimewa yang diperlukan untuk memuat data dari bucket Amazon S3 yang ditentukan.
Untuk memuat data Anda sendiri dari Amazon S3 ke Amazon Redshift, Anda dapat menggunakan wizard memuat data editor kueri v2. Untuk informasi tentang cara menggunakan panduan memuat data, lihat Memuat data dari Amazon S3 di Panduan Manajemen Amazon Redshift.
Buat data TICKIT di cluster Anda
TICKIT adalah database sampel yang dapat Anda muat secara opsional ke cluster Amazon Redshift Anda untuk tujuan mempelajari cara menanyakan data di Amazon Redshift. Anda dapat membuat set lengkap tabel TICKIT dan memuat data ke cluster Anda dengan cara berikut:
Saat membuat cluster di konsol Amazon Redshift, Anda memiliki opsi untuk memuat sampel data TICKIT secara bersamaan. Di konsol Amazon Redshift, pilih Clu ster, Buat cluster. Di bagian Data sampel, pilih Muat data sampel Amazon Redshift memuat dataset sampelnya ke
devdatabase cluster Amazon Redshift Anda secara otomatis selama pembuatan cluster.Untuk terhubung ke cluster yang ada, lakukan hal berikut:
Di konsol Amazon Redshift, pilih Cluster dari bilah navigasi.
Pilih cluster Anda dari panel Cluster.
Pilih Data kueri, Kueri di editor kueri v2.
Perluas examplecluster dalam daftar sumber daya. Jika ini adalah pertama kalinya Anda terhubung ke cluster Anda, Connect to exampleclu ster muncul. Pilih nama pengguna dan kata sandi database. Biarkan database sebagai
dev. Tawsuserentukan nama pengguna danChangeit1kata sandi.Pilih Buat koneksi.
Dengan editor kueri Amazon Redshift v2, Anda dapat memuat data TICKIT ke dalam database sampel bernama sample_data_dev. Pilih database sample_data_dev dalam daftar sumber daya. Di sebelah simpul tickit, pilih ikon Open sample notebook. Konfirmasikan bahwa Anda ingin membuat database sampel.
Editor kueri Amazon Redshift v2 membuat database sampel bersama dengan buku catatan sampel bernama tic kit-sample-notebook. Anda dapat memilih J alankan semua untuk menjalankan buku catatan ini untuk menanyakan data dalam database sampel.
Untuk melihat detail tentang data TICKIT, lihat Contoh database di Panduan Pengembang Database Amazon Redshift.
Langkah 5: Coba contoh kueri menggunakan editor kueri
Untuk mengatur dan menggunakan editor kueri Amazon Redshift v2 untuk menanyakan database, lihat Bek erja dengan editor kueri v2 di Panduan Manajemen Amazon Redshift.
Sekarang, coba beberapa contoh kueri, seperti yang ditunjukkan berikut. Untuk membuat kueri baru di editor kueri v2, pilih ikon +di kanan atas panel kueri, dan pilih SQL. Halaman kueri baru muncul di mana Anda dapat menyalin dan menempelkan kueri SQL berikut.
catatan
Pastikan untuk menjalankan kueri pertama di buku catatan terlebih dahulu, yang menetapkan nilai konfigurasi search_path server ke tickit skema menggunakan perintah SQL berikut:
set search_path to tickit;
Untuk informasi selengkapnya tentang bekerja dengan perintah SELECT, lihat SEL ECT di Panduan Pengembang Database Amazon Redshift.
-- Get definition for the sales table.
SELECT *
FROM pg_table_def
WHERE tablename = 'sales';
-- Find total sales on a given calendar date.
SELECT sum(qtysold)
FROM   sales, date
WHERE  sales.dateid = date.dateid
AND    caldate = '2008-01-05';
-- Find top 10 buyers by quantity.
SELECT firstname, lastname, total_quantity
FROM   (SELECT buyerid, sum(qtysold) total_quantity
        FROM  sales
        GROUP BY buyerid
        ORDER BY total_quantity desc limit 10) Q, users
WHERE Q.buyerid = userid
ORDER BY Q.total_quantity desc;
-- Find events in the 99.9 percentile in terms of all time gross sales.
SELECT eventname, total_price
FROM  (SELECT eventid, total_price, ntile(1000) over(order by total_price desc) as percentile
       FROM (SELECT eventid, sum(pricepaid) total_price
             FROM   sales
             GROUP BY eventid)) Q, event E
       WHERE Q.eventid = E.eventid
       AND percentile = 1
ORDER BY total_price desc;
Langkah 6: Setel ulang lingkungan Anda
Pada langkah sebelumnya, Anda telah berhasil membuat cluster Amazon Redshift, memuat data ke dalam tabel, dan menanyakan data menggunakan klien SQL seperti editor kueri Amazon Redshift v2.
Ketika Anda telah menyelesaikan tutorial ini, kami sarankan Anda mengatur ulang lingkungan Anda ke keadaan sebelumnya dengan menghapus cluster sampel Anda. Anda terus dikenakan biaya untuk layanan Amazon Redshift sampai Anda menghapus cluster.
Namun, Anda mungkin ingin agar cluster sampel tetap berjalan jika Anda ingin mencoba tugas di panduan atau tugas Amazon Redshift lainnya yang dijelaskan diJalankan perintah untuk mendefinisikan dan menggunakan database di gudang data Anda.
Untuk menghapus klaster
-
Masuk ke Konsol Manajemen AWS dan buka konsol Amazon Redshift di https://console.aws.amazon.com/redshiftv2/
. -
Pada menu navigasi, pilih Cluster untuk menampilkan daftar cluster Anda.
-
Pilih
exampleclustercluster. Untuk Tindakan, pilih Hapus. H apus contoh luster? halaman muncul. -
Konfirmasikan cluster yang akan dihapus, hapus centang pada pengaturan Buat snapshot akhir, lalu masukkan
deleteuntuk mengonfirmasi penghapusan. Pilih Hapus cluster.
Pada halaman daftar cluster, status cluster diperbarui saat cluster dihapus.
Setelah Anda menyelesaikan tutorial ini, Anda dapat menemukan informasi lebih lanjut tentang Amazon Redshift dan langkah-langkah selanjutnya diSumber daya tambahan untuk mempelajari tentang Amazon Redshift.
